ES相关介绍和安装
主要记录下ES的概念,安装和使用。
概念
倒排索引
倒排索引的概念是基于MySQL这样的正向索引而言的。
正向索引
设置了索引的话挺快的,但要是模糊查询则就很慢!
那么什么是正向索引呢?例如给下表(tb_goods)中的id创建索引:
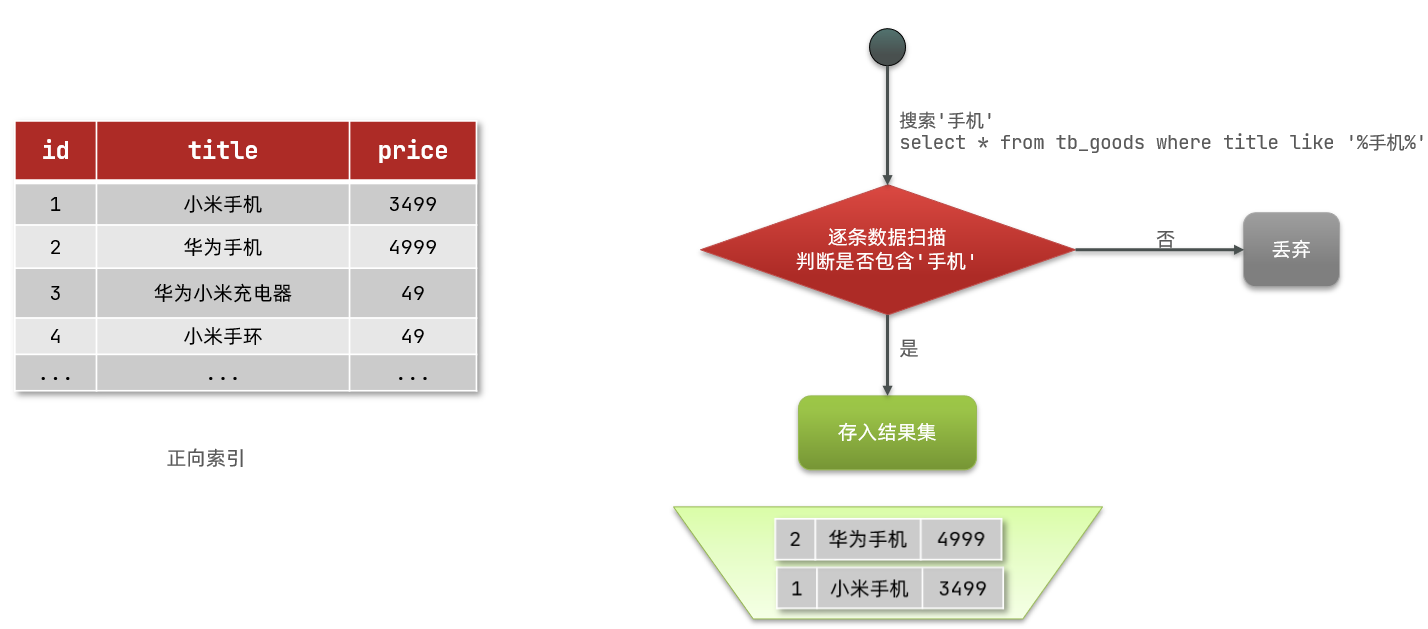
如果是根据id查询,那么直接走索引,查询速度非常快。
但如果是基于title做模糊查询,只能是逐行扫描数据,流程如下:
1)用户搜索数据,条件是title符合”%手机%”
2)逐行获取数据,比如id为1的数据
3)判断数据中的title是否符合用户搜索条件
4)如果符合则放入结果集,不符合则丢弃。回到步骤1
逐行扫描,也就是全表扫描,随着数据量增加,其查询效率也会越来越低。当数据量达到数百万时,就是一场灾难。
倒排索引
倒排索引中有两个非常重要的概念:
- 文档(Document):用来搜索的数据,其中的每一条数据就是一个文档。例如一个网页、一个商品信息
- 词条(Term):对文档数据或用户搜索数据,利用某种算法分词,得到的具备含义的词语就是词条。例如:我是中国人,就可以分为:我、是、中国人、中国、国人这样的几个词条
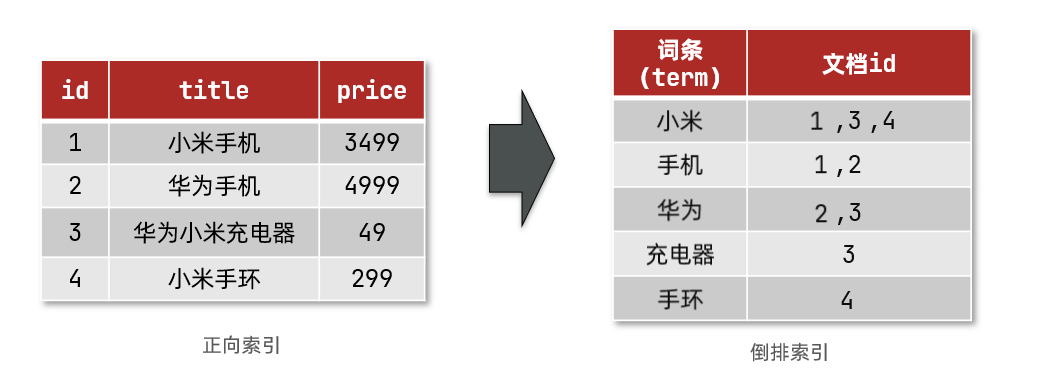
创建倒排索引是对正向索引的一种特殊处理,流程如下:
- 将每一个文档的数据利用算法分词,得到一个个词条
- 创建表,每行数据包括词条、词条所在文档id、位置等信息
- 因为词条唯一性,可以给词条创建索引,例如hash表结构索引
如图:
倒排索引的搜索流程如下(以搜索”华为手机”为例):
1)用户输入条件"华为手机"进行搜索。
2)对用户输入内容分词,得到词条:华为、手机。
3)拿着词条在倒排索引中查找,可以得到包含词条的文档id:1、2、3。
4)拿着文档id到正向索引中查找具体文档。
如图:
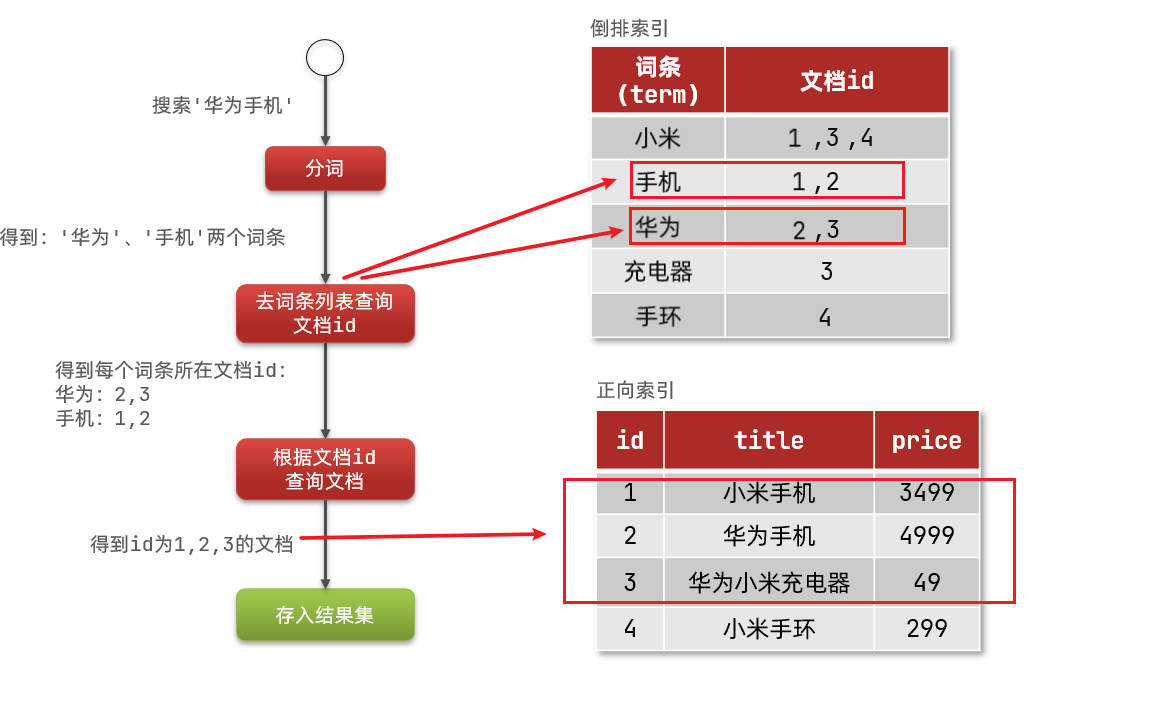
虽然要先查询倒排索引,再查询倒排索引,但是无论是词条、还是文档id都建立了索引,查询速度非常快!无需全表扫描。
正向和倒排对比
概念区别:
正向索引是最传统的,根据id索引的方式。但根据词条查询时,必须先逐条获取每个文档,然后判断文档中是否包含所需要的词条,是根据文档找词条的过程。
而倒排索引则相反,是先找到用户要搜索的词条,根据词条得到保护词条的文档的id,然后根据id获取文档。是根据词条找文档的过程。
ES数据库基本概念
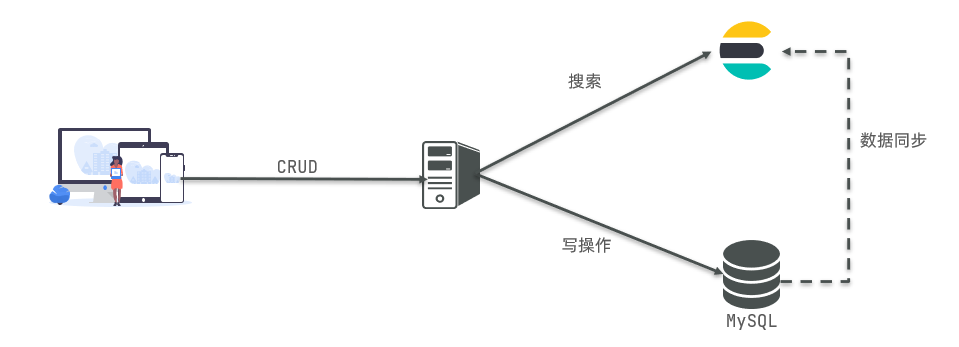
elasticsearch中有很多独有的概念,与mysql中略有差别,但也有相似之处。
文档和字段
一个文档就像数据库里的一条数据,字段就像数据库里的列
elasticsearch是面向文档(Document)存储的,可以是数据库中的一条商品数据,一个订单信息。文档数据会被序列化为json格式后存储在elasticsearch中:
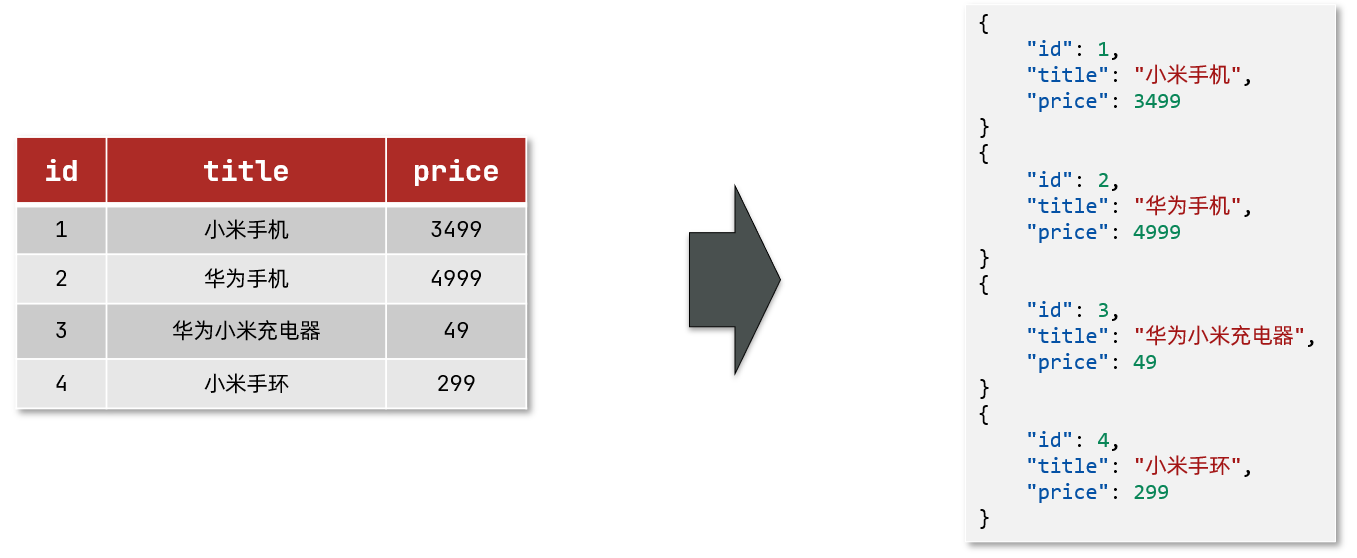
而Json文档中往往包含很多的字段(Field),类似于mysql数据库中的列。
索引和映射
索引就像数据库里的表,映射就像数据库中定义的表结构
索引(Index),就是相同类型的文档的集合【类似mysql中的表】
例如:
- 所有用户文档,就可以组织在一起,称为用户的索引;
- 所有商品的文档,可以组织在一起,称为商品的索引;
- 所有订单的文档,可以组织在一起,称为订单的索引;
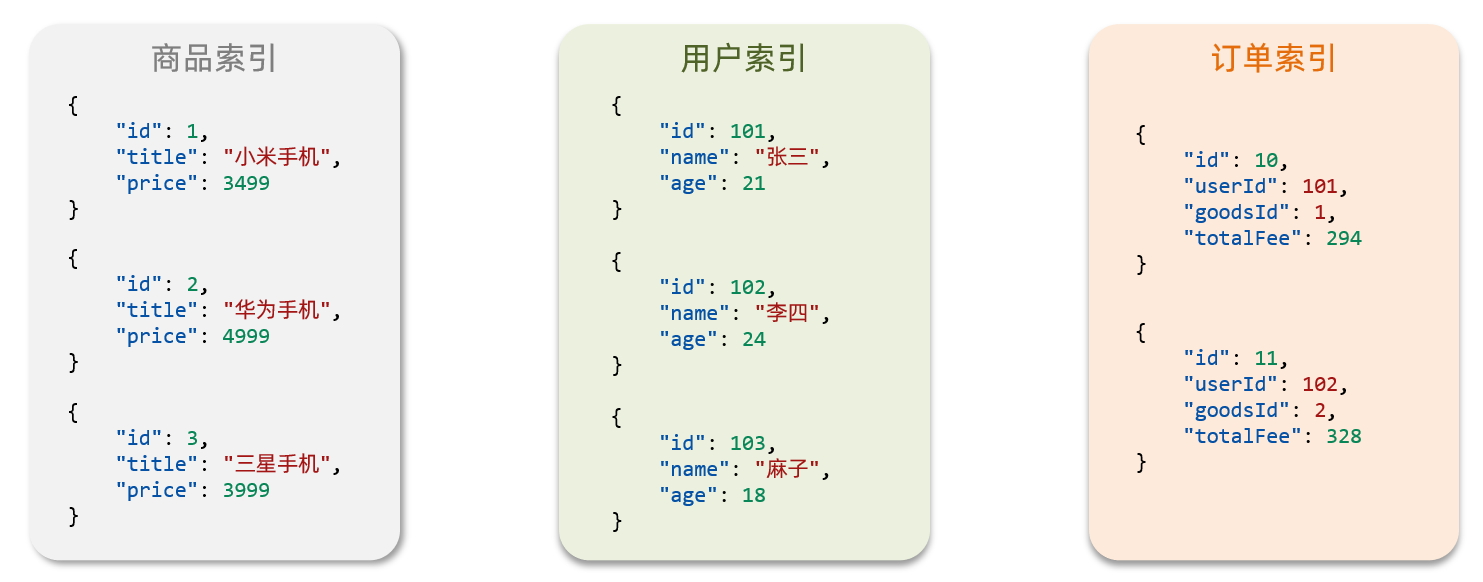
因此,我们可以把索引当做是数据库中的表。
数据库的表会有约束信息,用来定义表的结构、字段的名称、类型等信息。因此,索引库中就有映射(mapping),是索引中文档的字段约束信息,类似表的结构约束。
mysql与elasticsearch
各自长处:
- Mysql:擅长事务类型操作,可以确保数据的安全和一致性
- Elasticsearch:擅长海量数据的搜索、分析、计算
我们统一的把mysql与elasticsearch的概念做一下对比:
| MySQL | Elasticsearch | 说明 |
|---|---|---|
| Table | Index | 索引(index),就是文档的集合,类似数据库的表(table) |
| Row | Document | 文档(Document),就是一条条的数据,类似数据库中的行(Row),文档都是JSON格式 |
| Column | Field | 字段(Field),就是JSON文档中的字段,类似数据库中的列(Column) |
| Schema | Mapping | Mapping(映射)是索引中文档的约束,例如字段类型约束。类似数据库的表结构(Schema) |
| SQL | DSL | DSL是elasticsearch提供的JSON风格的请求语句,用来操作elasticsearch,实现CRUD |
ES和Kibana安装
ES安装
JDK依赖问题
ES优先使用系统的jdk,如果版本不一致就会报错
1 | warning: usage of JAVA_HOME is deprecated, use ES_JAVA_HOME |
解决办法: 使用es自带的jdk, 修改 bin/elasticsearch , 添加下面内容
1 | ############# 添加配置解决jdk版本问题 ############## |
- 修改内存
config/jvm.options
1 | -Xms1024m |
创建专用用户
不能使用root启动,需要创建专用的用户。 can not run elasticsearch as root
- 创建用户
useradd esuser
- 创建所属组
chown esuser:esuser -R elasticsearch-7.12.1
- 切换用户
su esuser
- 启动
./elasticsearch -d
修改配置
修改文件 elasticsearch.yml
修改ip
network.host: 0.0.0.0
初始化节点名称
1
2
3cluster.name: elasticsearch
node.name: es-node0
cluster.initial_master_nodes: ["es-node0"]
常见错误
- max file descriptors [4096] for elasticsearch process is too low
1 | 使用root |
- max virtual memory areas vm.max_map_count [65530] is too low, increase to at least [262144]
elasticsearch用户拥有的内存权限太小,至少需要262144,解决办法:
vim /etc/sysctl.conf , 添加
vm.max_map_count=262144
保存,刷新配置
sysctl -p
启动后,访问 curl http://127.0.0.1:9200 出现如下信息,说明成功
1 | { |
如果使用ip无法访问的话,可以看下,是否是机器防火墙的问题。
Kibana安装
chown esuser:esuser -R kibana-7.12.1-linux-x86_64
- 修改
config/kibana.yml配置
1 | server.port:http访问端口 |
启动
nohup ./kibana &
访问
浏览器访问 http://ip:5601 , 能访问,说明成功。
可以在页面上添加 Sample data 进行测试
可以在discover 页面进行查询
http://localhost:5601/app/discover
配置密码访问
参考官方文档 security-minimal-setup
- Stop both Kibana and Elasticsearch if they are running
- 修改
ES_PATH_CONF/elasticsearch.yml文件, 并设置为 true
1 | xpack.security.enabled: true |
- 启动es,
./elasticsearch -d - 生成随机密码
./bin/elasticsearch-setup-passwords auto - 设置密码之后, 不能二次执行
elasticsearch-setup-passwords - 修改
KIB_PATH_CONF/kibana.yml, 添加
elasticsearch.username: “kibana_system”
Create the Kibana keystore
./bin/kibana-keystore create
Add the password for the kibana_system user to the Kibana keystore
./bin/kibana-keystore add elasticsearch.password
启动kibana
ES集群
集群安装
因为本地机器有限,所以在同一台机器上进行集群的安装。
将 elasticsearch-7.12.1-linux-x86_64.tar.gz 解压后复制成三份,分别修改对应的配置
配置信息如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18node-1
cluster.initial_master_nodes: ["node-1", "node-2", "node-3"]
cluster.name: es-cluster
discovery.seed_hosts: ["node-1:9205", "node-2:9206", "node-3:9207"]
network.host: 0.0.0.0
http.port: 9200
node.name: node-1
transport.port: 9205
node-2 前面几项一样
http.port: 9201
node.name: node-2
transport.port: 9206
node-3
http.port: 9202
node.name: node-2
transport.port: 9207修改 hosts 中映射
1
2
310.1.40.136 node-1
10.1.40.136 node-2
10.1.40.136 node-3调整 jvm.options 内存,按实际调整
分别启动各个node,观察启动日志和状态。
查看集群是否启动成功
1 | ip heap.percent ram.percent cpu load_1m load_5m load_15m node.role master name |
- 查看健康情况
1 | curl http://localhost:9202/_cat/health?v |
集群监控
推荐使用cerebro来监控es集群状态,官方网址:https://github.com/lmenezes/cerebro
需要JDK11以上,下载地址 。
创建索引
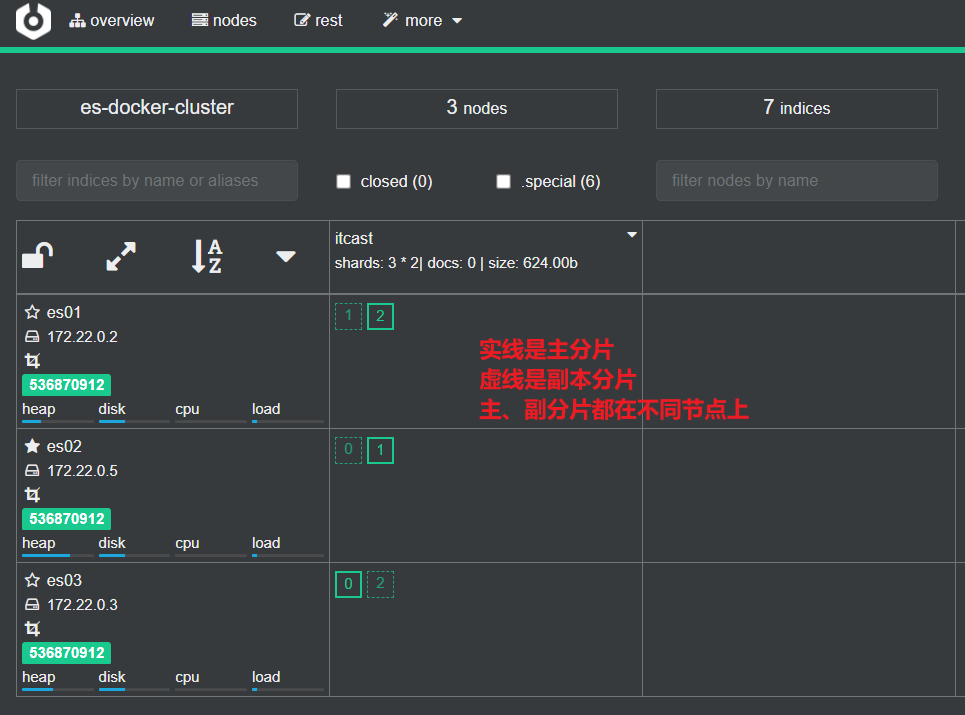
创建索引库的时候需要设置分片数量(其他还有多少个ES服务在该集群)以及副本数量(本服务的数据拷贝几份)
1 | PUT /testshard |
可以在监控上查看分片效果
集群脑裂问题
master eligible节点的作用是什么?
- 参与集群选主
- 主节点可以管理集群状态、管理分片信息、处理创建和删除索引库的请求
data节点的作用是什么?
- 数据的CRUD
coordinator节点的作用是什么?
路由请求到其它节点
合并查询到的结果,返回给用户
集群职责划分
通过改变配置文件中的 true——> false 来改变职责。如data数据职责节点就只保留data为true其他为false
注意:每个节点都是路由,这样可以保证不管哪个节点接收到请求可以分给其他人已经从其他人那接收信息。
elasticsearch中集群节点有不同的职责划分:
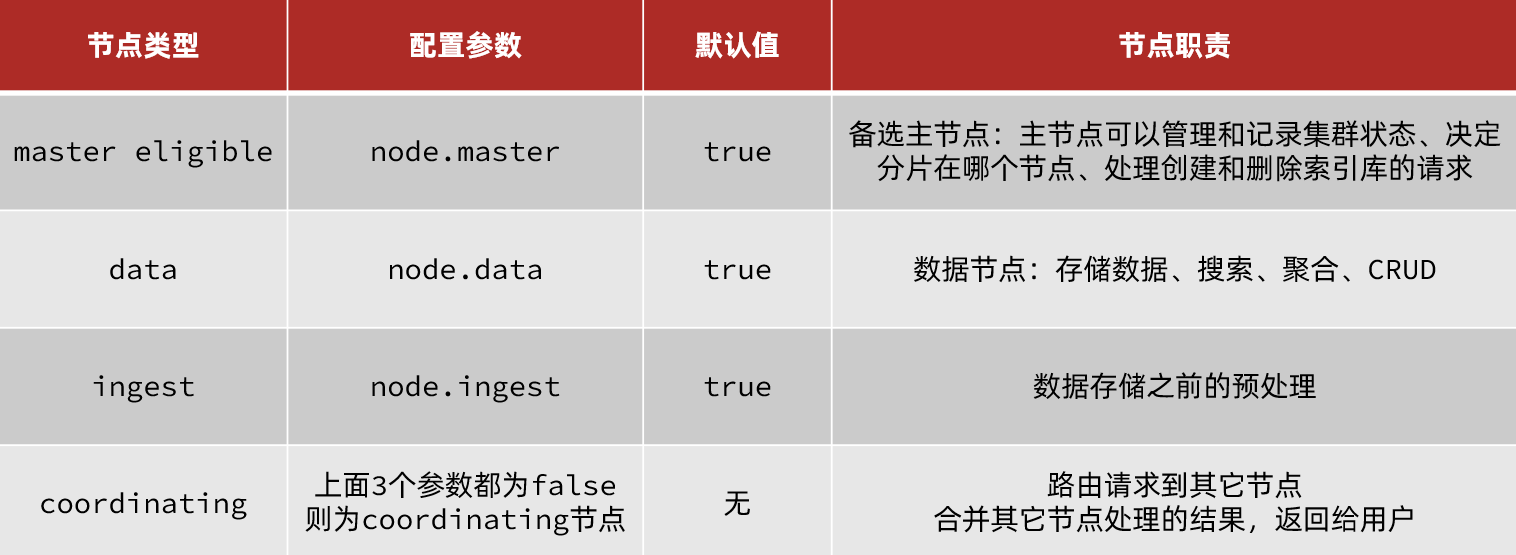
默认情况下,集群中的任何一个节点都同时具备上述四种角色。
但是真实的集群一定要将集群职责分离:(因为不同职责对CPU要求不同)
- master节点:对CPU要求高,但是内存要求低
- data节点:对CPU和内存要求都高
- coordinating节点:对网络带宽、CPU要求高
职责分离可以让我们根据不同节点的需求分配不同的硬件去部署。而且避免业务之间的互相干扰。
一个典型的es集群职责划分如图: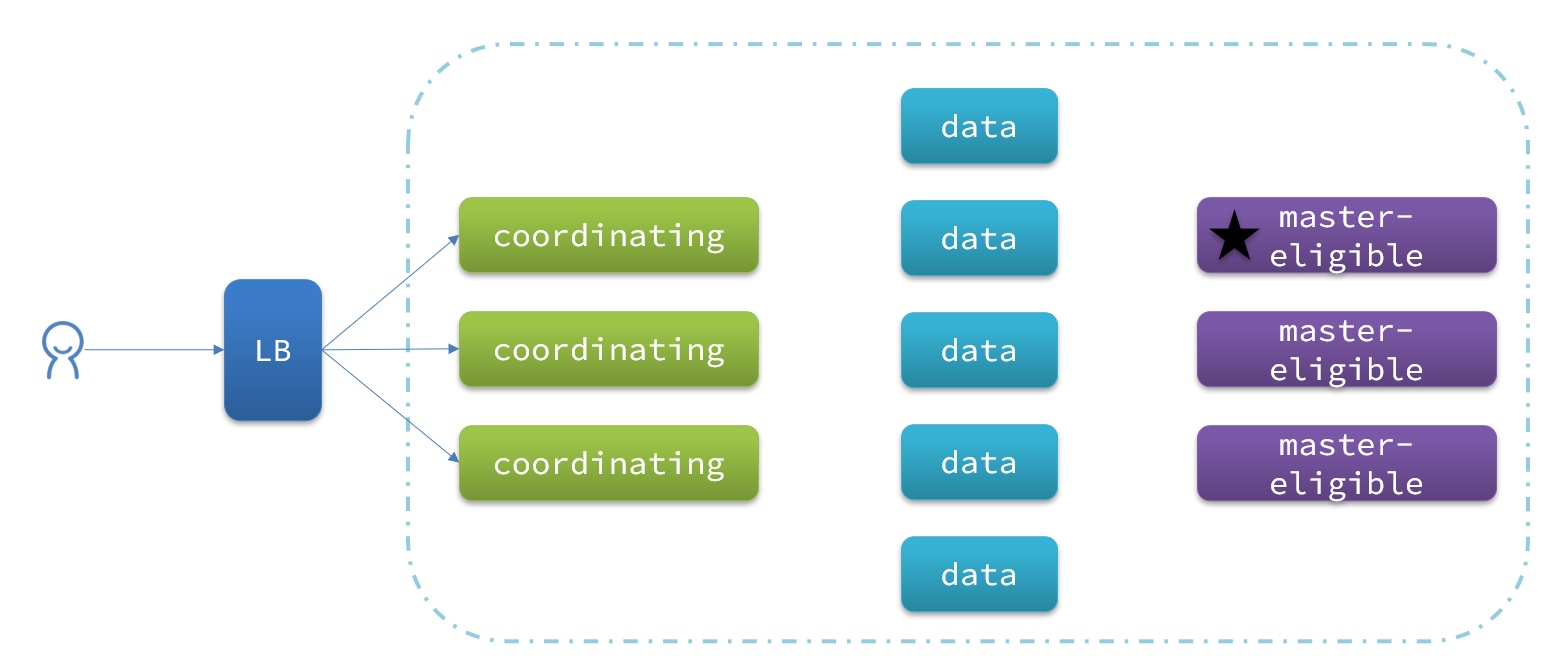
脑裂问题
ES 7.0后默认配置了 ( eligible节点数量 + 1 )/ 2 来解决脑裂问题
脑裂是因为集群中的节点失联导致的。
例如一个集群中,主节点与其它节点失联:
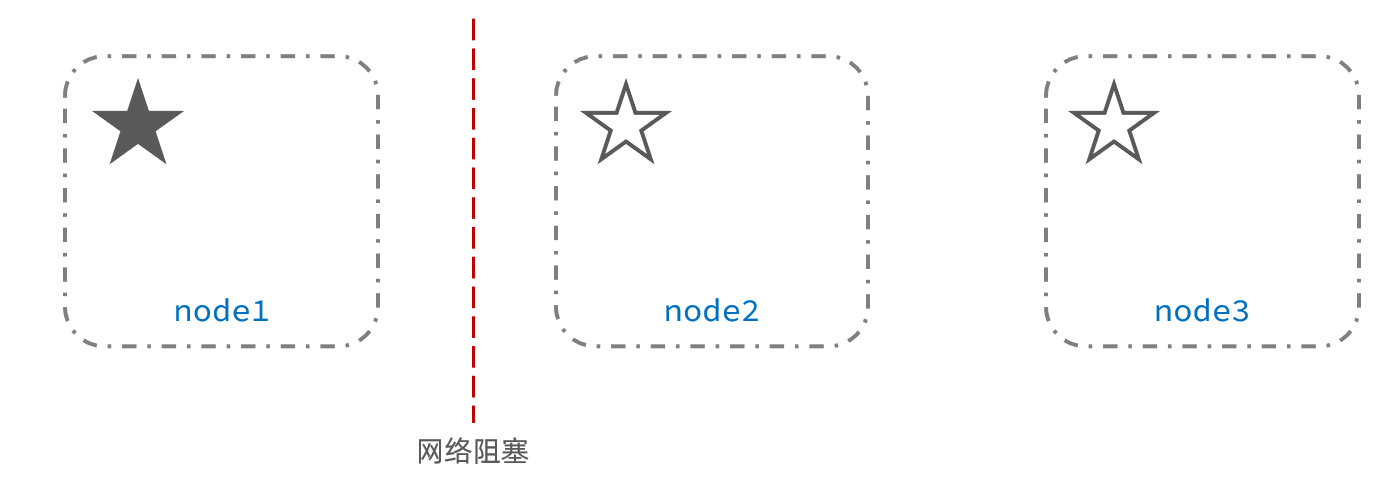
此时,node2和node3认为node1宕机,就会重新选主:
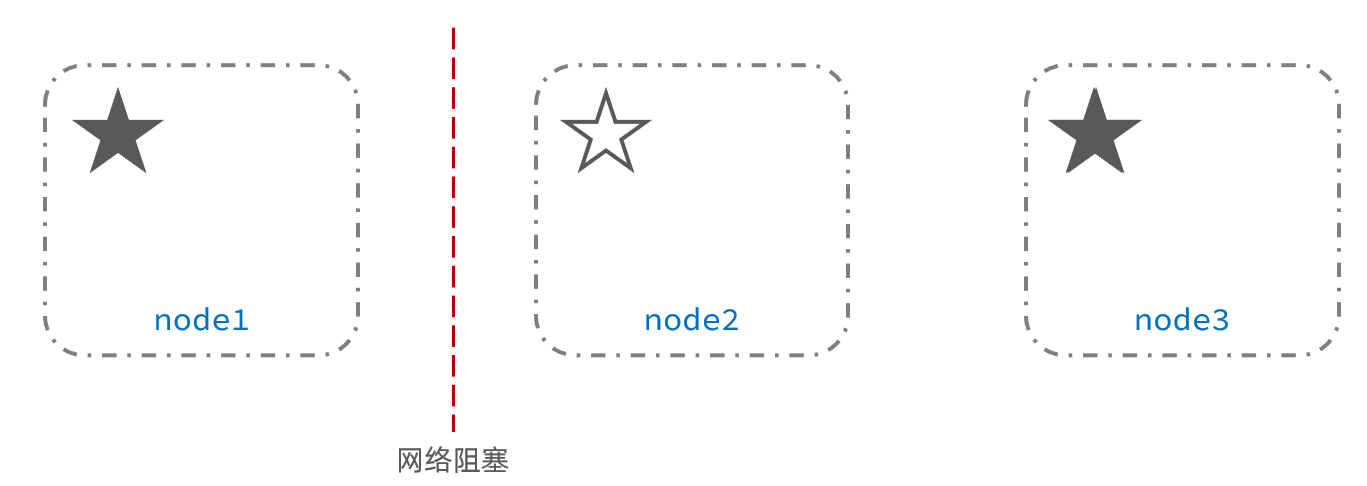
当node3当选后,集群继续对外提供服务,node2和node3自成集群,node1自成集群,两个集群数据不同步,出现数据差异。
当网络恢复后,因为集群中有两个master节点,集群状态的不一致,出现脑裂的情况:
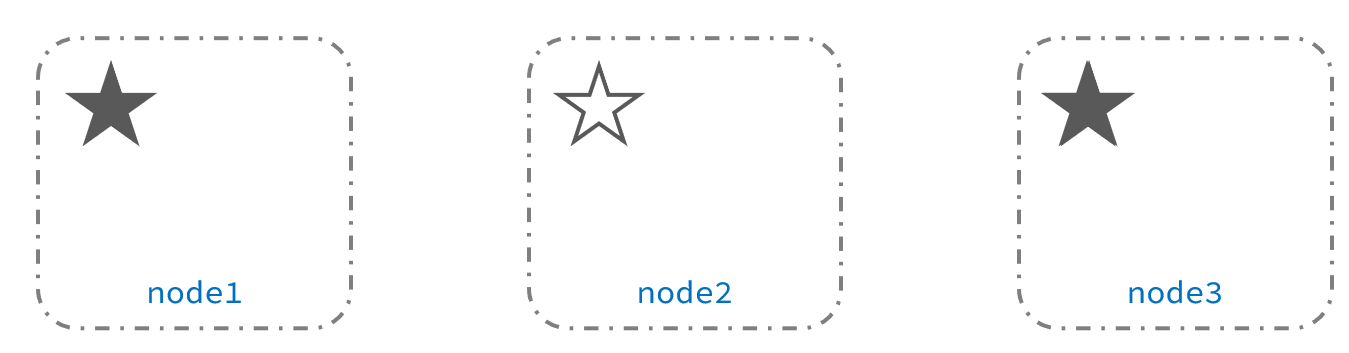
解决脑裂的方案是,要求选票超过 ( eligible节点数量 + 1 )/ 2 才能当选为主,因此eligible节点数量最好是奇数。对应配置项是discovery.zen.minimum_master_nodes,在es7.0以后,已经成为默认配置,因此一般不会发生脑裂问题
例如:3个节点形成的集群,选票必须超过 (3 + 1) / 2 ,也就是2票。node3得到node2和node3的选票,当选为主。node1只有自己1票,没有当选。集群中依然只有1个主节点,没有出现脑裂。
集群分布式存储
当新增文档时,应该保存到不同分片,保证数据均衡,那么coordinating node如何确定数据该存储到哪个分片呢?
多插入几条数据,然后进行查询,可以看到数据分布在不同的分片上
1 | GET /testshard1/_search |
分片存储原理
elasticsearch会通过hash算法来计算文档应该存储到哪个分片:
shard = hash(_routing) % number_of_shards
说明:
- _routing默认是文档的id
- 算法与分片数量有关,因此索引库一旦创建,分片数量不能修改!
新增文档的流程如下:
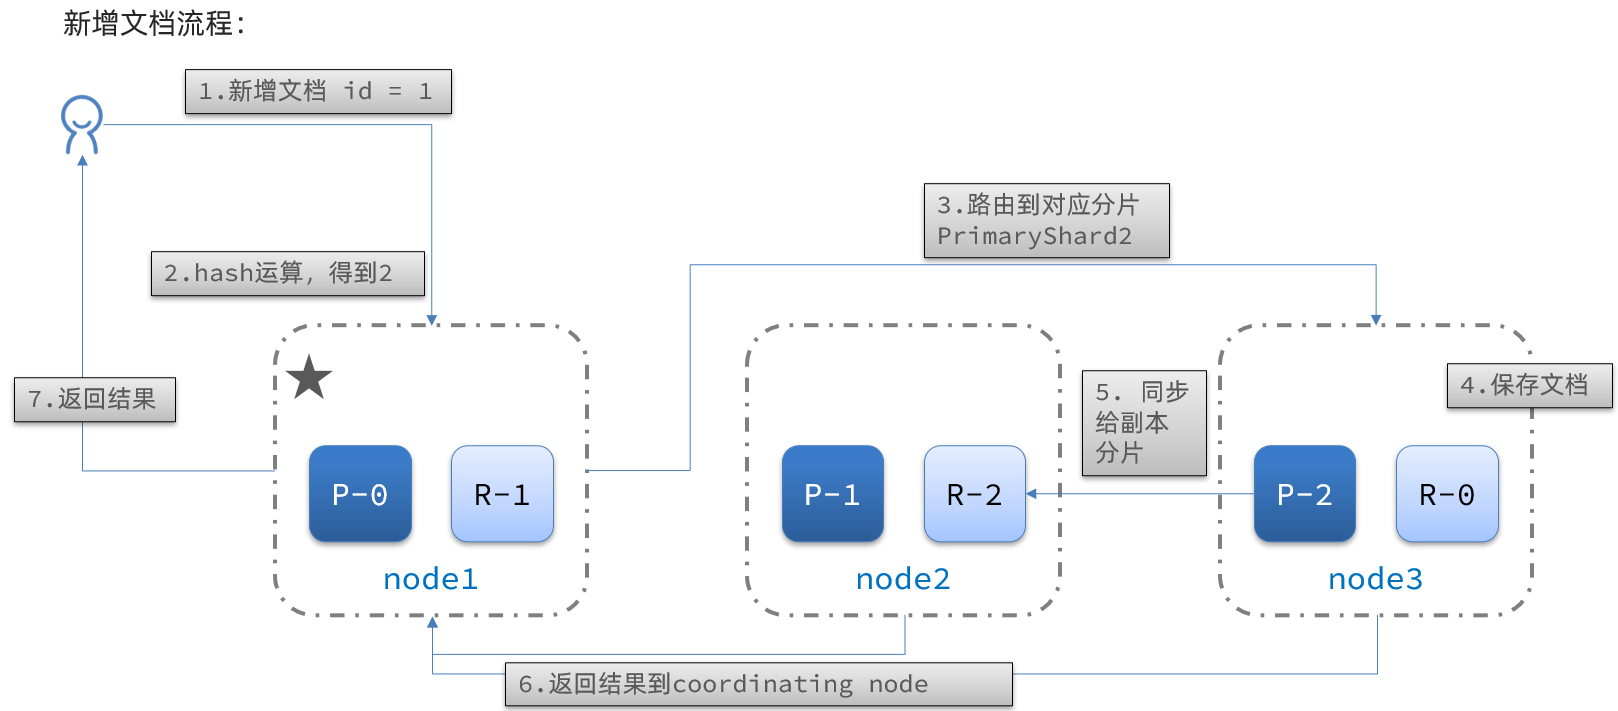
解读:
- 1)新增一个id=1的文档
- 2)对id做hash运算,假如得到的是2,则应该存储到shard-2
- 3)shard-2的主分片在node3节点,将数据路由到node3
- 4)保存文档
- 5)同步给shard-2的副本replica-2,在node2节点
- 6)返回结果给coordinating-node节点
集群分布式查询
原理:
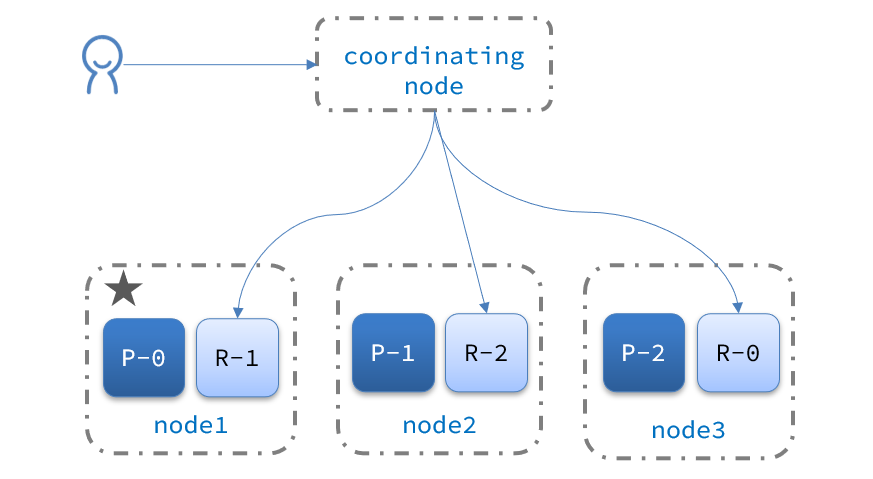
elasticsearch的查询分成两个阶段:
scatter phase:分散阶段,coordinating node会把请求分发到每一个分片
gather phase:聚集阶段,coordinating node汇总data node的搜索结果,并处理为最终结果集返回给用户
集群故障转移
ES本身已经配置好了有集群故障转移,不需要我们再去配置
集群的master节点会监控集群中的节点状态,如果发现有节点宕机,会立即将宕机节点的分片数据迁移到其它节点,确保数据安全,这个叫做故障转移。
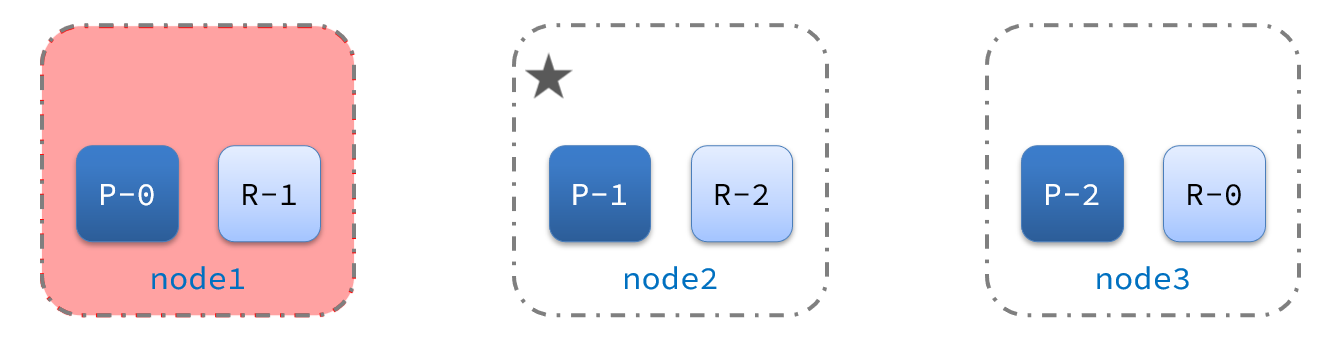
1)例如一个集群结构如图:
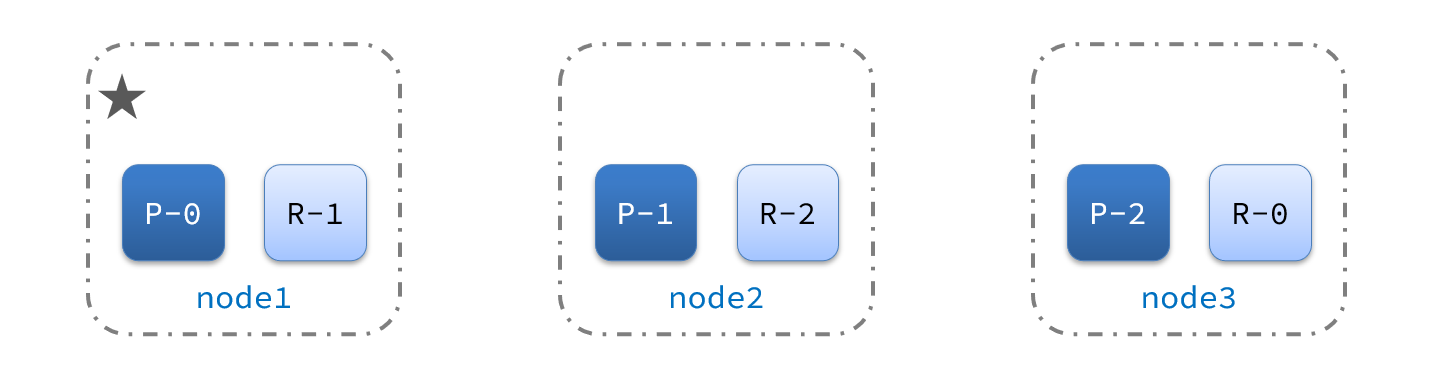
现在,node1是主节点,其它两个节点是从节点。
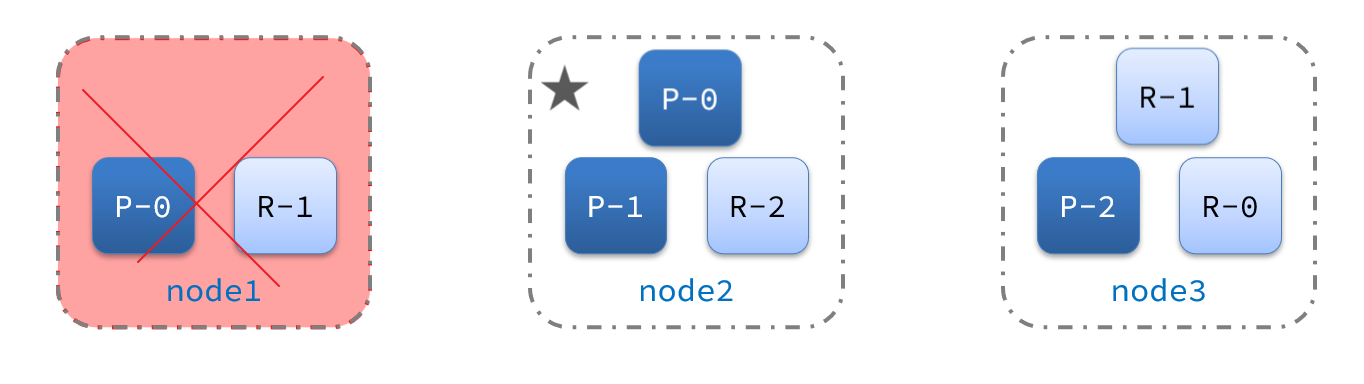
2)突然,node1发生了故障:
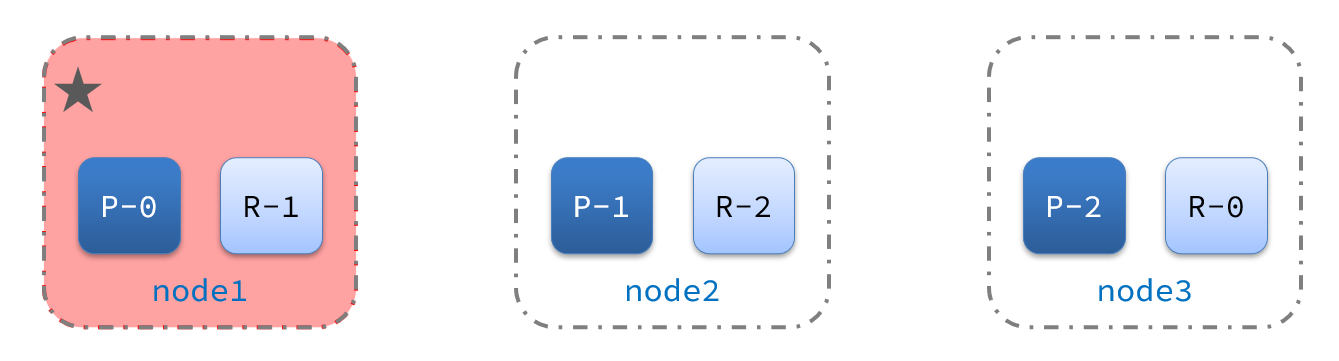
宕机后的第一件事,需要重新选主,例如选中了node2:
node2成为主节点后,会检测集群监控状态,发现:shard-1、shard-0没有副本节点。因此需要将node1上的数据迁移到node2、node3:
安装分词器
可以在线安装,或者离线下载后解压到plugins目录下面
- 在线安装
./elasticsearch-plugin install https://release.infinilabs.com/analysis-ik/stable/elasticsearch-analysis-ik-7.12.1.zip
如果是集群的ES,需要每个node下都安装一遍。
验证
IK分词器包含两种模式:
ik_smart:最少切分ik_max_word:最细切分
在kibana的Dev tools中输入以下代码:
”analyzer“ 就是选择分词器模式
1 | GET /_analyze |
结果
1 | { |
扩展词词典
随着互联网的发展,“造词运动”也越发的频繁。出现了很多新的词语,在原有的词汇列表中并不存在。比如:“奥力给”,“白嫖” 等。
所以我们的词汇也需要不断的更新,IK分词器提供了扩展词汇的功能。
1)打开IK分词器目录 config/analysis-ik:
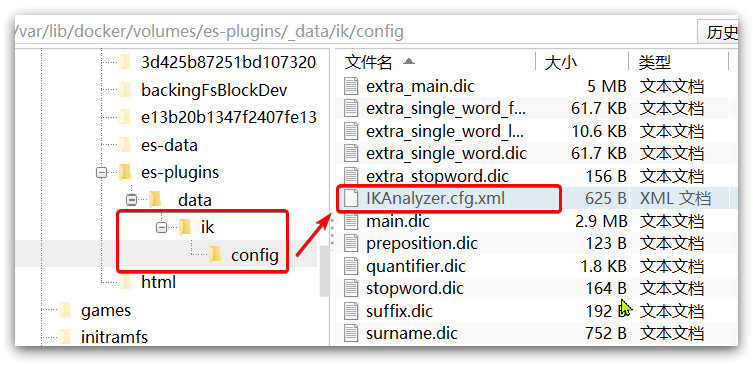
2)在IKAnalyzer.cfg.xml配置文件内容添加:
1 |
|
3)新建一个 ext.dic,可以参考config目录下复制一个配置文件进行修改
1 | 白嫖 |
4)重启elasticsearch, 查看日志中的加载情况
1 | [2025-01-17T14:38:30,348][INFO ][o.w.a.d.Dictionary ] [es-node0] try load config from /usr/local/elasticsearch/elasticsearch-7.12.1/config/analysis-ik/IKAnalyzer.cfg.xml |
注意当前文件的编码必须是 UTF-8 格式,严禁使用Windows记事本编辑
停用词词典
在互联网项目中,在网络间传输的速度很快,所以很多语言是不允许在网络上传递的,如:关于宗教、政治等敏感词语,那么我们在搜索时也应该忽略当前词汇。
IK分词器也提供了强大的停用词功能,让我们在索引时就直接忽略当前的停用词汇表中的内容。
1)IKAnalyzer.cfg.xml配置文件内容添加:
1 | <entry key="ext_stopwords">stopword.dic</entry> |
2)在 stopword.dic 添加停用词
1 | 傻逼 |
3)重启elasticsearch
4)测试效果
参考文章