RestAPI的使用 Java High Level REST Client 7.12
需要注意的是, 此api对应的es版本为7.12.1,目前此api已被官方标记为deprecated,如果使用新的es版本的话,需要使用新的api java-api-client 。
API操作索引库
JavaRestClient操作elasticsearch的流程基本类似。核心是client.indices()方法来获取索引库的操作对象。
索引库操作的基本步骤:【可以根据发送请求那步的第一个参数,来判断需要创建什么XXXXRequest】
- 初始化RestHighLevelClient
- 创建XxxIndexRequest。XXX是Create、Get、Delete
- 准备DSL( Create时需要,其它是无参)
- 发送请求。调用RestHighLevelClient#indices().xxx()方法,xxx是create、exists、delete
mapping映射分析
根据MySQL数据库表结构(建表语句),去写索引库结构JSON。表和索引库一一对应
注意:地理坐标、组合字段。索引库里的地理坐标是一个字段:坐标:维度,精度 。copy_to组合字段作用是供用户查询(输入关键字可以查询多个字段)
创建索引库,最关键的是mapping映射,而mapping映射要考虑的信息包括:
- 字段名
- 字段数据类型
- 是否参与搜索
- 是否需要分词
- 如果分词,分词器是什么?
其中:
- 字段名、字段数据类型,可以参考数据表结构的名称和类型
- 是否参与搜索要分析业务来判断,例如图片地址,就无需参与搜索
- 是否分词呢要看内容,内容如果是一个整体就无需分词,反之则要分词
- 分词器,我们可以统一使用ik_max_word
来看下酒店数据的索引库结构:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
| PUT /hotel
{
"mappings": {
"properties": {
"id": {
"type": "keyword"
},
"name":{
"type": "text",
"analyzer": "ik_max_word",
"copy_to": "all"
},
"address":{
"type": "keyword",
"index": false
},
"price":{
"type": "integer"
},
"score":{
"type": "integer"
},
"brand":{
"type": "keyword",
"copy_to": "all"
},
"city":{
"type": "keyword",
"copy_to": "all"
},
"starName":{
"type": "keyword"
},
"business":{
"type": "keyword"
},
"location":{
"type": "geo_point"
},
"pic":{
"type": "keyword",
"index": false
},
"all":{
"type": "text",
"analyzer": "ik_max_word"
}
}
}
}
|
几个特殊字段说明:
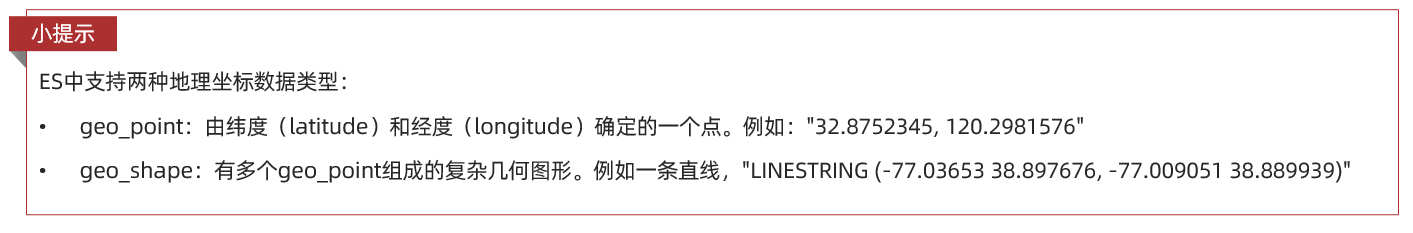
- location:地理坐标,里面包含精度、纬度
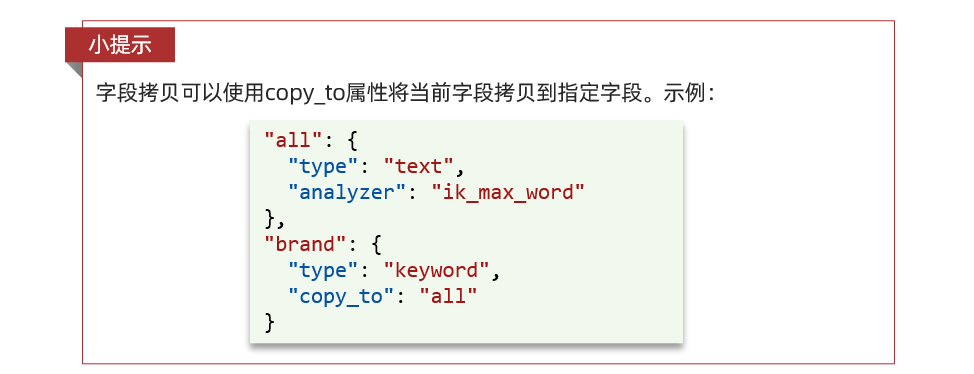
- all:一个组合字段,其目的是将多字段的值 利用copy_to合并,提供给用户搜索
地理坐标说明:
![image]()
copy_to说明:
![image]()
初始化RestClient
在elasticsearch提供的API中,与elasticsearch一切交互都封装在一个名为RestHighLevelClient的类中,必须先完成这个对象的初始化,建立与elasticsearch的连接。
分为三步:
1)引入es的RestHighLevelClient依赖:
1
2
3
4
5
6
| <dependency>
<groupId>org.elasticsearch.client</groupId>
<artifactId>elasticsearch-rest-high-level-client</artifactId>
<version>7.12.1</version>
</dependency>
|
2)初始化RestHighLevelClient:这里一般在启动类或者配置类里注入该Bean,用于告诉Java 访问ES的ip地址
1
2
3
4
5
6
7
8
9
10
|
RestHighLevelClient client;

@BeforeEach
public void init(){
    client = new RestHighLevelClient(
    RestClient.builder(
    new HttpHost("10.1.40.136", 9200, "http")));
}
|
索引库CRUD
创建索引库
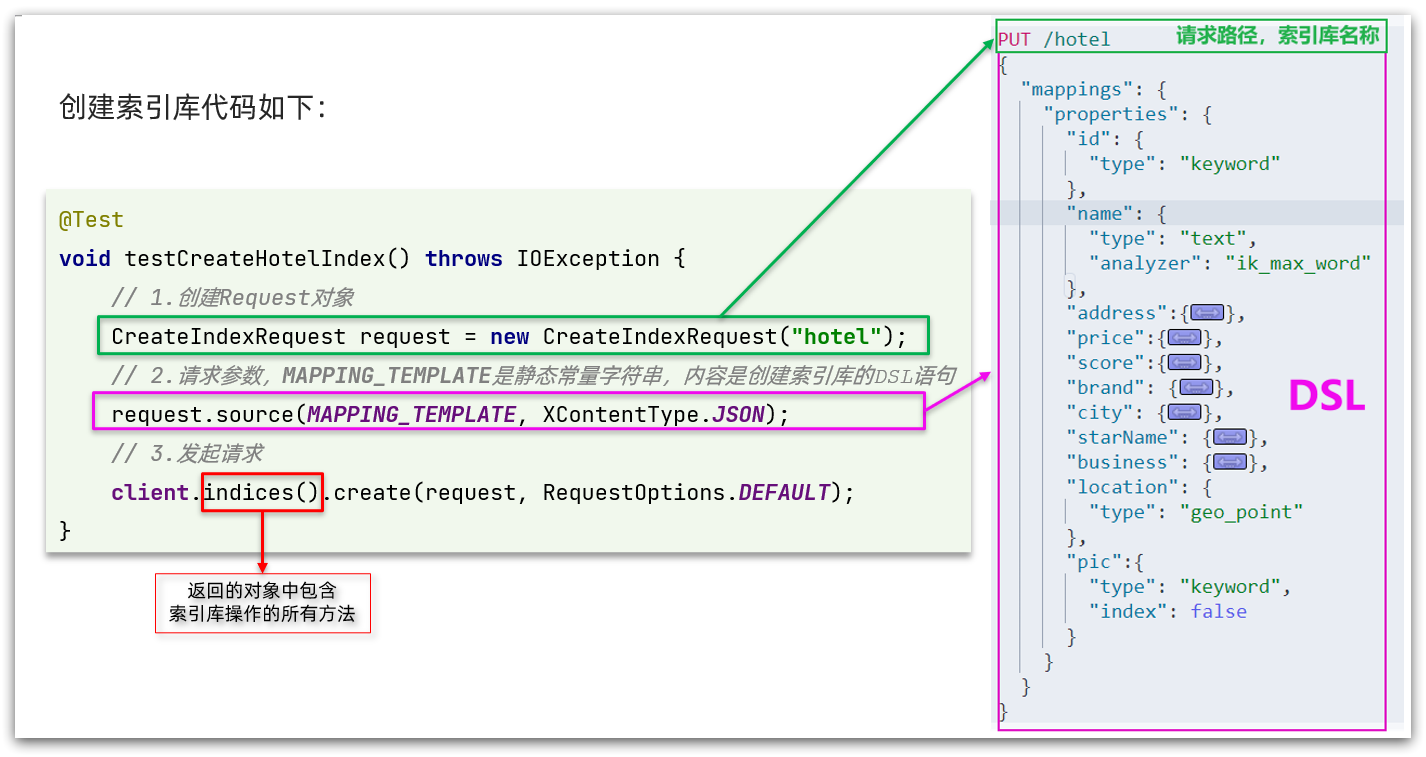
代码分为三步:
- 1)创建Request对象。因为是创建索引库的操作,因此Request是CreateIndexRequest。
- 2)添加请求参数,其实就是DSL的JSON参数部分。因为json字符串很长,这里是定义了静态字符串常量MAPPING_TEMPLATE,让代码看起来更加优雅。
- 3)发送请求,client.indices()方法的返回值是IndicesClient类型,封装了所有与索引库操作有关的方法。
创建索引库的API如下:
![image]()
单元测试的代码
1
2
3
4
5
6
7
8
9
10
11
12
| @Test
void createHotelIndex() throws IOException {
CreateIndexRequest request = new CreateIndexRequest("hotel");
request.source(json, XContentType.JSON);
CreateIndexResponse createIndexResponse = client.indices().create(request, RequestOptions.DEFAULT);
log.info("创建索引的结果为 {}", createIndexResponse.isAcknowledged());
}
|
删除索引库
三步走:
- 1)创建Request对象。这次是DeleteIndexRequest对象
- 2)准备参数。这里是无参
- 3)发送请求。改用delete方法
删除索引库的DSL语句非常简单:
1
2
3
4
5
6
7
8
9
| @Test
public void testDeleteHotelIndex() throws IOException {
DeleteIndexRequest request = new DeleteIndexRequest("hotel");
AcknowledgedResponse acknowledgedResponse = client.indices().delete(request, RequestOptions.DEFAULT);
log.info("删除索引的结果为 {}", acknowledgedResponse.isAcknowledged());
}
|
查询索引库
三步走:
- 1)创建Request对象。这次是GetIndexRequest对象
- 2)准备参数。这里是无参
- 3)发送请求。改用exists方法
判断索引库是否存在,本质就是查询,对应的DSL是:
1
2
3
4
5
6
7
8
9
10
|
@Test
void testExistsHotelIndex() throws IOException {
GetIndexRequest request = new GetIndexRequest("hotel");
boolean exists = client.indices().exists(request, RequestOptions.DEFAULT);
log.info("索引是否存在 {}", exists);
}
|
API操作文档
这里更多的是先读取Mysql中的数据,然后再存进ES中。
文档操作的基本步骤:【可以根据发送请求那步的第一个参数,反过来判断需要创建什么XXXXRequest】
- 初始化RestHighLevelClient
- 创建XxxRequest。XXX是Index、Get、Update、Delete、Bulk
- 准备参数(Index、Update、Bulk时需要)
- 发送请求。调用RestHighLevelClient#.xxx()方法,xxx是index、get、update、delete、bulk
- 解析结果(Get时需要)
初始化RestHighLevelClient 的操作和索引库的一样。
批量导入文档
三步走:
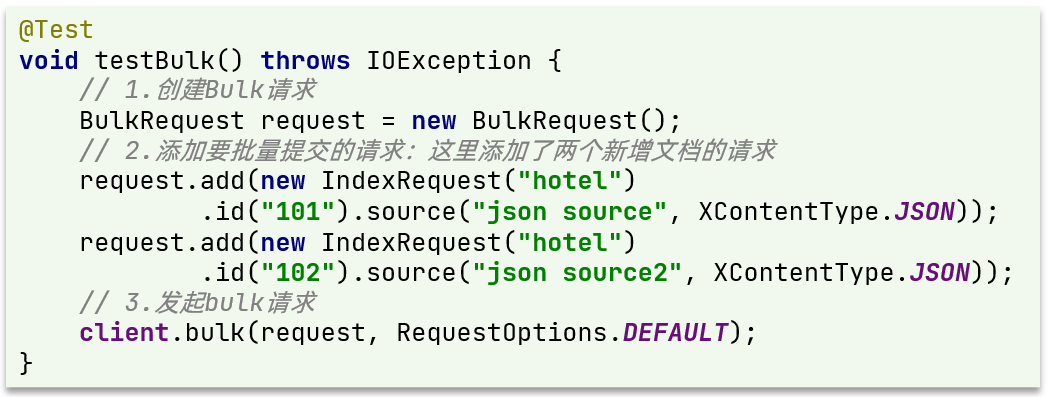
- 1)创建Request对象。这里是BulkRequest
- 2)准备参数。批处理的参数,就是其它Request对象,这里就是多个IndexRequest
- 3)发起请求。这里是批处理,调用的方法为client.bulk()方法
案例需求:利用BulkRequest批量将数据库数据导入到索引库中。
步骤如下:
- 利用mybatis-plus查询酒店数据
- 将查询到的酒店数据(Hotel)转换为文档类型数据(HotelDoc)
- 利用JavaRestClient中的BulkRequest批处理,实现批量新增文档
语法说明:
批量处理BulkRequest,其本质就是将多个普通的CRUD请求组合在一起发送。
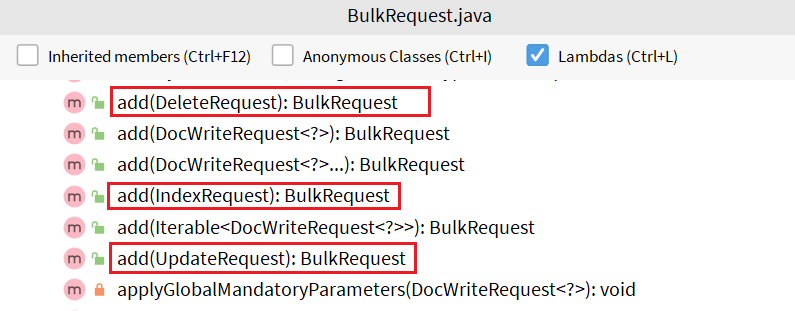
其中提供了一个add方法,用来添加其他请求:
![image]()
可以看到,能添加的请求包括:
- IndexRequest,也就是新增
- UpdateRequest,也就是修改
- DeleteRequest,也就是删除
因此Bulk中添加了多个IndexRequest,就是批量新增功能了。示例:
![image]()
1
2
3
4
5
6
7
8
| @Test
public void testBulk() throws IOException {
BulkRequest bulkRequest = new BulkRequest();
bulkRequest.add(new IndexRequest("testcrud").id("2").source("{\"age\":10,\"info\":\"我是中国人\"}", XContentType.JSON));
bulkRequest.add(new IndexRequest("testcrud").id("3").source("{\"age\":15,\"info\":\"这是一段测试的文本内容\"}", XContentType.JSON));
BulkResponse response = client.bulk(bulkRequest, RequestOptions.DEFAULT);
log.info("批量添加文档的结果 {}", Arrays.stream(response.getItems()).collect(Collectors.toMap(BulkItemResponse::getId, BulkItemResponse::status)));
}
|
批量新增文档
四步走:
- 0)创建索引库实体类
- 1)创建Request对象
- 2)准备请求参数,也就是DSL中的JSON文档
- 3)发送请求 (注意:这里直接使用client.xxx()的API,不再需要client.indices()了)
我们要将数据库的酒店数据查询出来,写入elasticsearch中。
1)创建索引库实体类
一般实体类里包含经纬度都需要创建一个新的实体类,将经纬度拼成一个字段
数据库查询后的结果是一个Hotel类型的对象。结构如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| @Data
@TableName("tb_hotel")
public class Hotel {
@TableId(type = IdType.INPUT)
private Long id;
private String name;
private String address;
private Integer price;
private Integer score;
private String brand;
private String city;
private String starName;
private String business;
private String longitude;
private String latitude;
private String pic;
}
|
与我们的索引库结构存在差异:
- longitude和latitude需要合并为location
因此,我们需要定义一个新的类型,与索引库结构吻合:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| package cn.itcast.hotel.pojo;
import lombok.Data;
import lombok.NoArgsConstructor;
@Data
@NoArgsConstructor
public class HotelDoc {
private Long id;
private String name;
private String address;
private Integer price;
private Integer score;
private String brand;
private String city;
private String starName;
private String business;
private String location;
private String pic;
public HotelDoc(Hotel hotel) {
this.id = hotel.getId();
this.name = hotel.getName();
this.address = hotel.getAddress();
this.price = hotel.getPrice();
this.score = hotel.getScore();
this.brand = hotel.getBrand();
this.city = hotel.getCity();
this.starName = hotel.getStarName();
this.business = hotel.getBusiness();
this.location = hotel.getLatitude() + ", " + hotel.getLongitude();
this.pic = hotel.getPic();
}
}
|
2)新增代码
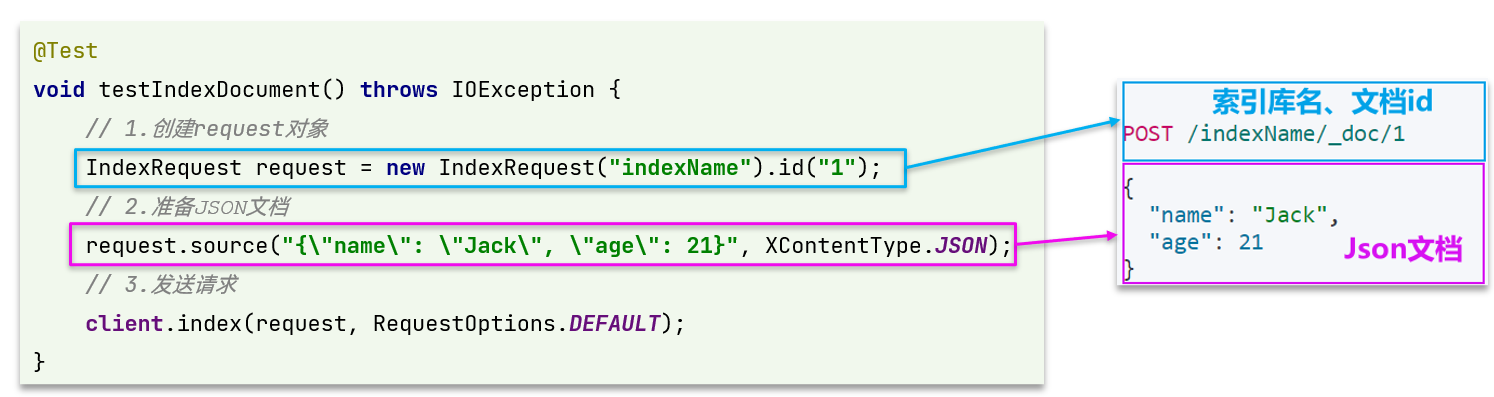
新增文档的DSL语句如下:
1
2
3
4
5
| POST /{索引库名}/_doc/1
{
"name": "Jack",
"age": 21
}
|
对应的java代码如图:
![image]()
我们导入酒店数据,基本流程一致,但是需要考虑几点变化:
- 酒店数据来自于数据库,我们需要先查询出来,得到hotel对象
- hotel对象需要转为HotelDoc对象
- HotelDoc需要序列化为json格式
查询文档
查询文档是根据id查询的,所以没有批量查询
三步走:
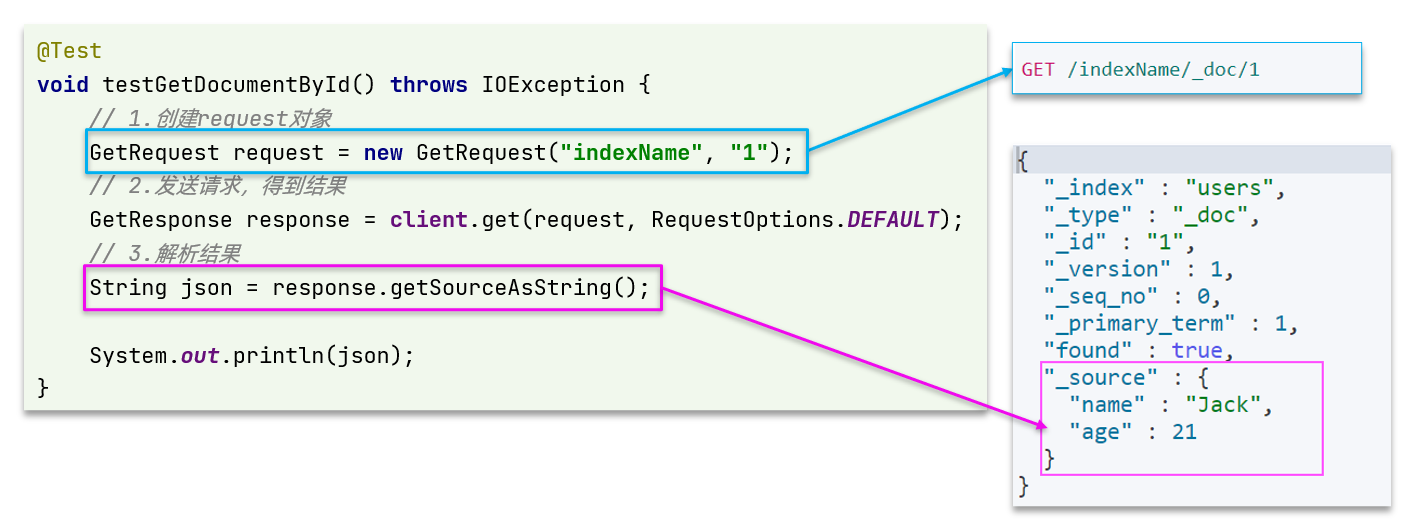
- 1)准备Request对象。这次是查询,所以是GetRequest
- 2)发送请求,得到结果。因为是查询,这里调用client.get()方法
- 3)解析结果,就是对JSON做反序列化
查询的DSL语句如下:
非常简单,因此代码大概分两步:
不过查询的目的是得到结果,解析为HotelDoc,因此难点是结果的解析。完整代码如下:
![image]()
可以看到,结果是一个JSON,其中文档放在一个_source属性中,因此解析就是拿到_source,使用工具反序列化为Java对象即可。
1
2
3
4
5
6
7
8
| @Test
public void testGetDocumentById() throws IOException {
GetRequest getRequest = new GetRequest("testcrud", "2");
GetResponse getResponse = client.get(getRequest, RequestOptions.DEFAULT);
log.info("查询文档的结果为 {}", getResponse.getSourceAsString());
}
|
批量删除文档
三步走:
- 1)准备Request对象,因为是删除,这次是DeleteRequest对象。要指定索引库名和id
- 2)准备参数,无参
- 3)发送请求。因为是删除,所以是client.delete()方法
删除的DSL为是这样的:
1
2
3
4
5
6
7
| @Test
public void testDeleteDocumentById() throws IOException {
DeleteRequest deleteRequest = new DeleteRequest("testcrud", "2");
DeleteResponse deleteResponse = client.delete(deleteRequest, RequestOptions.DEFAULT);
log.info("删除文档的结果为 {}", deleteResponse.status());
}
|
批量修改文档
三步走:
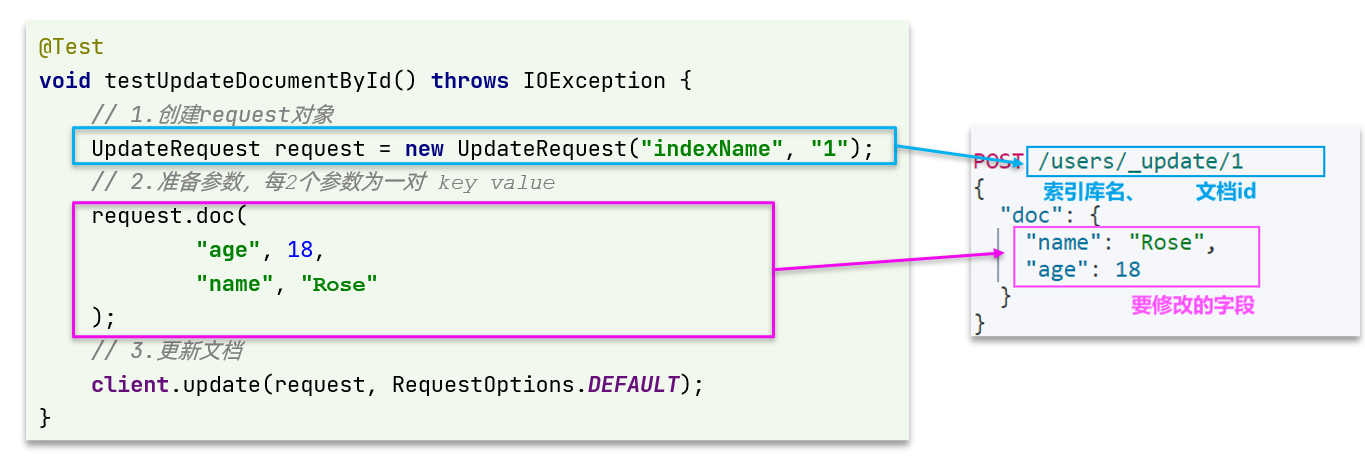
- 1)准备Request对象。这次是修改,所以是UpdateRequest
- 2)准备参数。也就是JSON文档,里面包含要修改的字段
- 3)更新文档。这里调用client.update()方法
修改有两种方式:
- 全量修改:本质是先根据id删除,再新增
- 增量修改:修改文档中的指定字段值
在RestClient的API中,全量修改与新增的API完全一致,判断依据是ID:
- 如果新增时,ID已经存在,则修改
- 如果新增时,ID不存在,则新增
只演示增量修改:
代码示例如图:
![image]()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| @Test
public void testUpdateDocumentById() throws IOException {
UpdateRequest updateRequest = new UpdateRequest("testcrud", "2");
Map<String, String> nameMap = new HashMap<>();
nameMap.put("firstName", "三");
nameMap.put("lastName", "张");
updateRequest.doc(
"info", "测试下name",
"name", nameMap
);
UpdateResponse updateResponse = client.update(updateRequest, RequestOptions.DEFAULT);
log.info("更新文档的结果为 {}", updateResponse.status().getStatus());
}
|
API查询文档
文档的查询同样适用 RestHighLevelClient对象,基本步骤包括:
- 1)准备Request对象
- 2)准备请求参数
- 3)发起请求
- 4)解析响应
快速入门
查询的基本步骤是:
查询的基本步骤是:
创建SearchRequest对象
准备Request.source(),也就是DSL。
① QueryBuilders来构建查询条件
② 传入Request.source() 的 query() 方法
发送请求,得到结果
解析结果(参考JSON结果,从外到内,逐层解析)
发送查询请求
![image]()
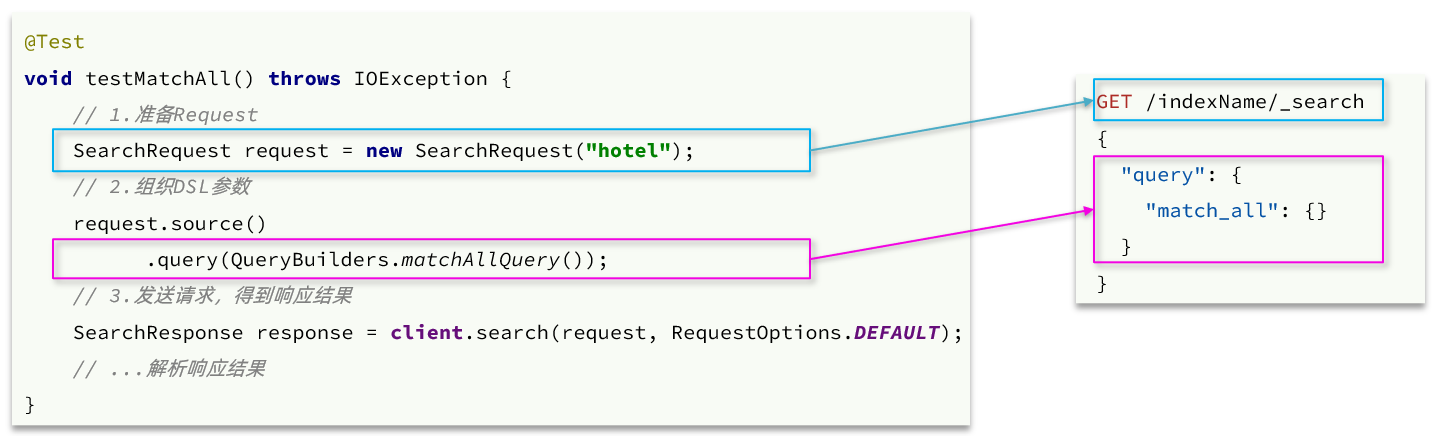
代码解读:
第一步,创建SearchRequest对象,指定索引库名
第二步,利用request.source()构建DSL,DSL中可以包含查询、分页、排序、高亮等
query():代表查询条件,利用QueryBuilders.matchAllQuery()构建一个match_all查询的DSL
第三步,利用client.search()发送请求,得到响应
这里关键的API有两个,一个是request.source(),其中包含了查询、排序、分页、高亮等所有功能:
另一个是QueryBuilders,其中包含match、term、function_score、bool等各种查询:
解析响应结果
响应结果的解析:
![image]()
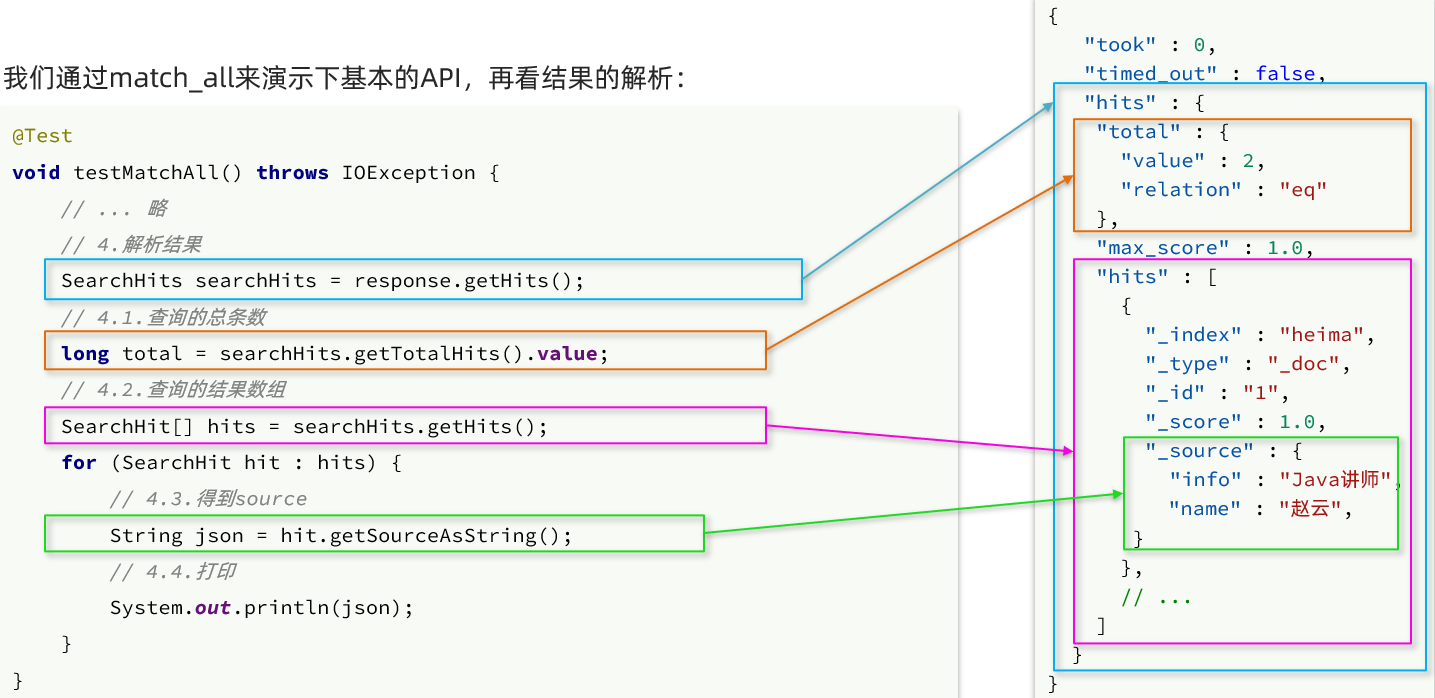
elasticsearch返回的结果是一个JSON字符串,结构包含:
hits:命中的结果
total:总条数,其中的value是具体的总条数值max_score:所有结果中得分最高的文档的相关性算分hits:搜索结果的文档数组,其中的每个文档都是一个json对象
_source:文档中的原始数据,也是json对象
因此,我们解析响应结果,就是逐层解析JSON字符串,流程如下:
SearchHits:通过response.getHits()获取,就是JSON中的最外层的hits,代表命中的结果
SearchHits#getTotalHits().value:获取总条数信息SearchHits#getHits():获取SearchHit数组,也就是文档数组
SearchHit#getSourceAsString():获取文档结果中的_source,也就是原始的json文档数据
设置查询条件
全文检索查询
全文检索的match和multi_match查询与match_all的API基本一致。差别是查询条件,也就是query的部分。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
|
# 全量查询
GET /testcrud/_search
{
  "query": {
    "match_all": {
    }
  }
}

# match 查询 keyword
GET /testcrud/_search
{
  "query": {
    "match": {
      "city": "上海市"
    }
  }
}

# multi_match 查询
GET /testcrud/_search
{
  "query": {
    "multi_match": {
      "query": "上海市",
      "fields": ["address", " city"]
    }
  }
}
|
因此,Java代码上的差异主要是 request.source().query() 中的参数了。同样是利用QueryBuilders提供的方法:
1
2
3
4
5
| SearchRequest request = new SearchRequest("kibana_sample_data_flights");
request.source().query(QueryBuilders.matchQuery("OriginWeather", "Sunny"));
request.source().query(QueryBuilders.multiMatchQuery("Sunny", "OriginWeather", "DestWeather"));
|
而结果解析代码则完全一致,可以抽取并共享。
精确查询
精确查询主要是两者:
与之前的查询相比,差异同样在查询条件,其它都一样。
查询条件构造的API如下:
1
2
| QueryBuilders.termQuery("DestCountry", "CN");
QueryBuilders.rangeQuery("FlightTimeMin").gte(100).lte(400);
|
地理查询
DSL查询
1
2
3
4
5
6
7
8
9
10
| GET /kibana_sample_data_flights/_search
{
"query": {
"geo_distance": {
"distance" : "50km",
"OriginLocation" : "44.7, 11.6"
}
}
}
|
代码如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| @Test
public void testGeoSearch() throws IOException {
SearchRequest request = new SearchRequest("kibana_sample_data_flights");
request.source().query(QueryBuilders.matchQuery("DestCountry", "CN"));
request.source().from(0).size(20);
request.source()
.sort(SortBuilders.fieldSort("FlightTimeMin").order(SortOrder.ASC))
.sort(SortBuilders.geoDistanceSort("DestLocation", 31.194265D, 121.44156D)
.order(SortOrder.ASC).unit(DistanceUnit.KILOMETERS));
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
SearchHits searchHits = response.getHits();
SearchHit[] hits = searchHits.getHits();
log.info("总条数 {}, 结果条数为 {} 结果数据 \r\n {}", searchHits.getTotalHits().value, hits.length, response.toString());
}
|
布尔查询
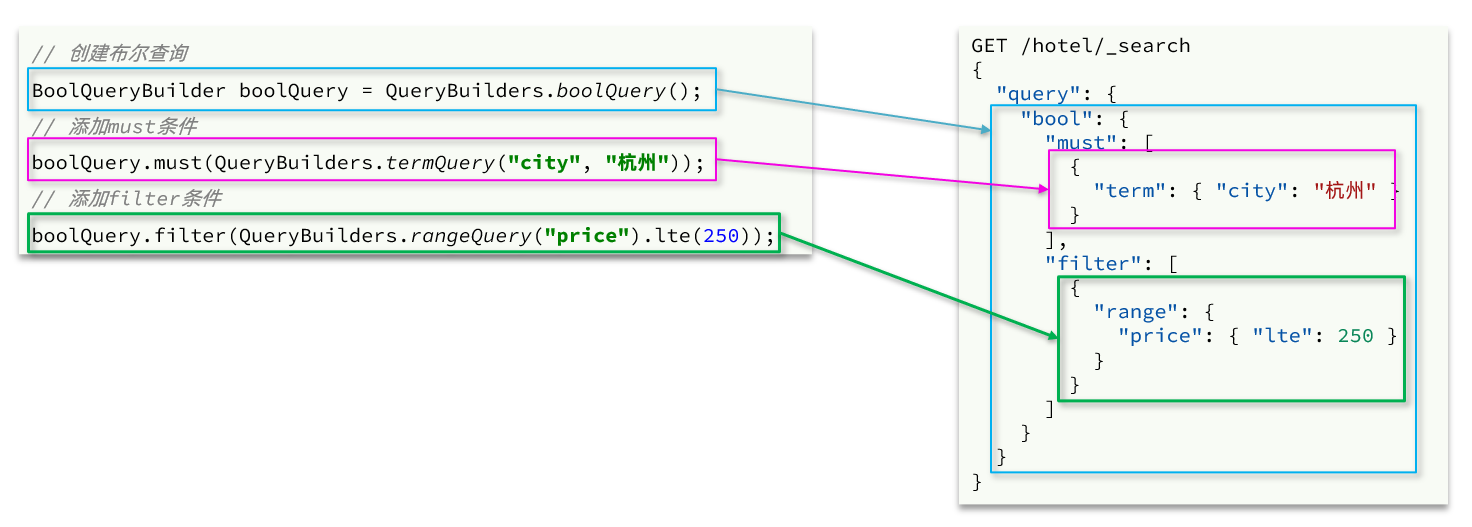
布尔查询是用must、must_not、filter等方式组合其它查询,代码示例如下:
![image]()
可以看到,API与其它查询的差别同样是在查询条件的构建,QueryBuilders,结果解析等其他代码完全不变。
代码如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
|
@Test
public void testBoolQuery() throws IOException {
SearchRequest request = new SearchRequest("kibana_sample_data_flights");
BoolQueryBuilder boolQuery = QueryBuilders.boolQuery();
boolQuery.must(QueryBuilders.termQuery("DestCountry", "CN"));
boolQuery.mustNot(QueryBuilders.multiMatchQuery("Rain", "OriginWeather", "DestWeather"));
boolQuery.filter(QueryBuilders.rangeQuery("AvgTicketPrice").lte(300));
request.source().query(boolQuery);
request.source().from(0).size(10);
request.source().sort("AvgTicketPrice");
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
log.info("查询结果为 {}", response.toString());
}
|
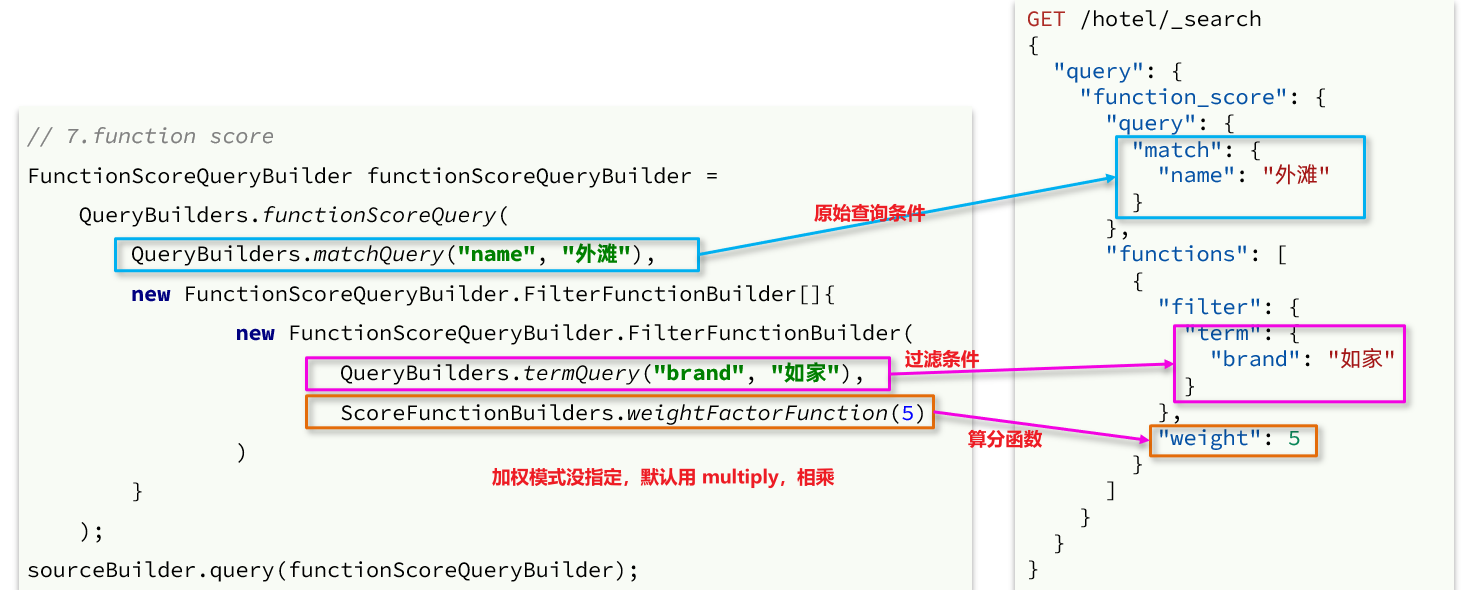
算分函数查询
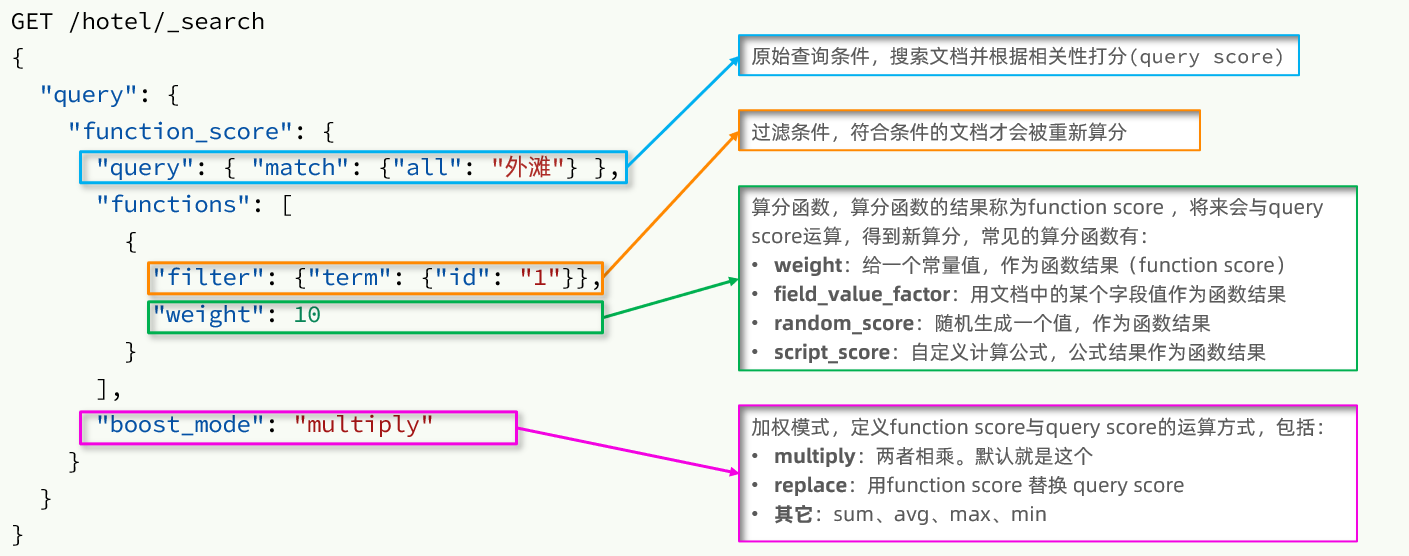
java代码逻辑:添加一个isAD字段,在算分函数的filter中判断isAD=ture就进行重新算分
function_score查询结构如下:
![image]()
对应的JavaAPI如下:
![image]()
我们可以将上一步的布尔查询作为原始查询条件放到query中,接下来就是添加过滤条件、算分函数、加权模式了。
1
2
3
4
5
6
7
8
| FunctionScoreQueryBuilder functionScoreQueryBuilder = QueryBuilders.functionScoreQuery(
boolQuery, new FunctionScoreQueryBuilder.FilterFunctionBuilder[]{
new FunctionScoreQueryBuilder.FilterFunctionBuilder(
QueryBuilders.multiMatchQuery("Sunny", "DestWeather", "OriginWeather"),
ScoreFunctionBuilders.weightFactorFunction(10F)
)
});
|
设置搜索结果
排序和分页
搜索结果的排序和分页是与query同级的参数,因此同样是使用request.source()来设置。
1
2
| request.source().from(0).size(10);
request.source().sort("AvgTicketPrice");
|
高亮
高亮的代码与之前代码差异较大,有两点:
- 查询的DSL:其中除了查询条件,还需要添加高亮条件,同样是与query同级。
- 结果解析:结果除了要解析_source文档数据,还要解析高亮结果
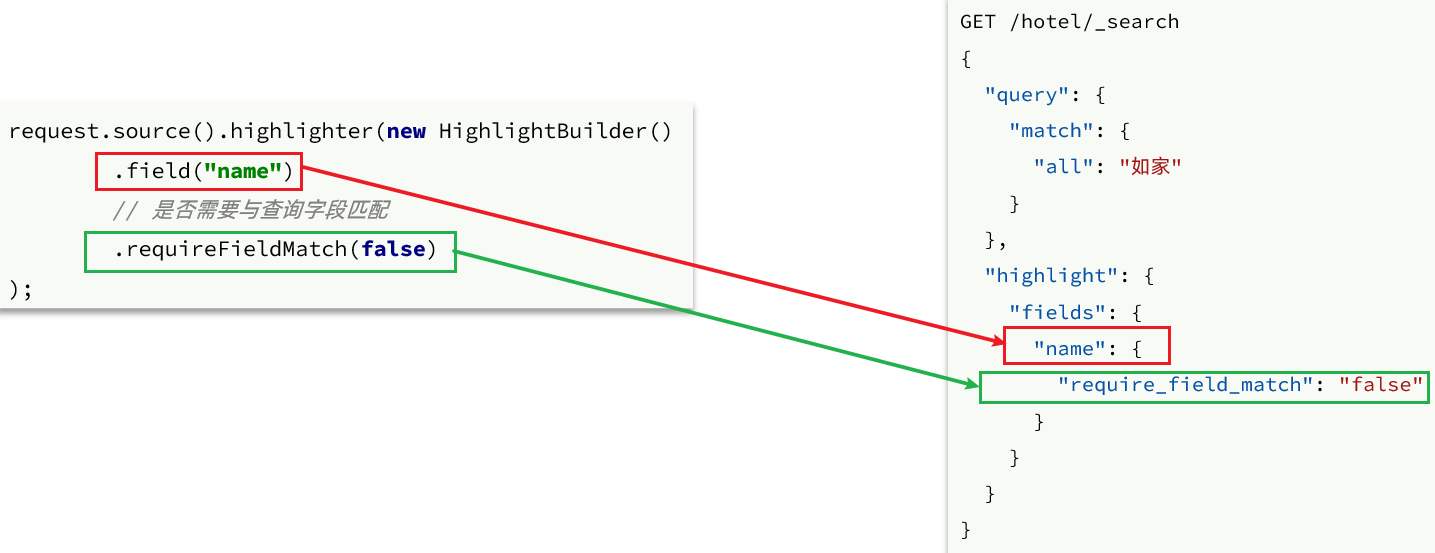
1)高亮请求构建
高亮请求的构建API如下:
![image]()
上述代码省略了查询条件部分,但是大家不要忘了:高亮查询必须使用全文检索查询,并且要有搜索关键字,将来才可以对关键字高亮。
完整代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| @Test
void testHighlight() throws IOException {
SearchRequest request = new SearchRequest("hotel");
request.source().query(QueryBuilders.matchQuery("all", "如家"));
request.source().highlighter(new HighlightBuilder().field("name").requireFieldMatch(false));
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
handleResponse(response);
}
|
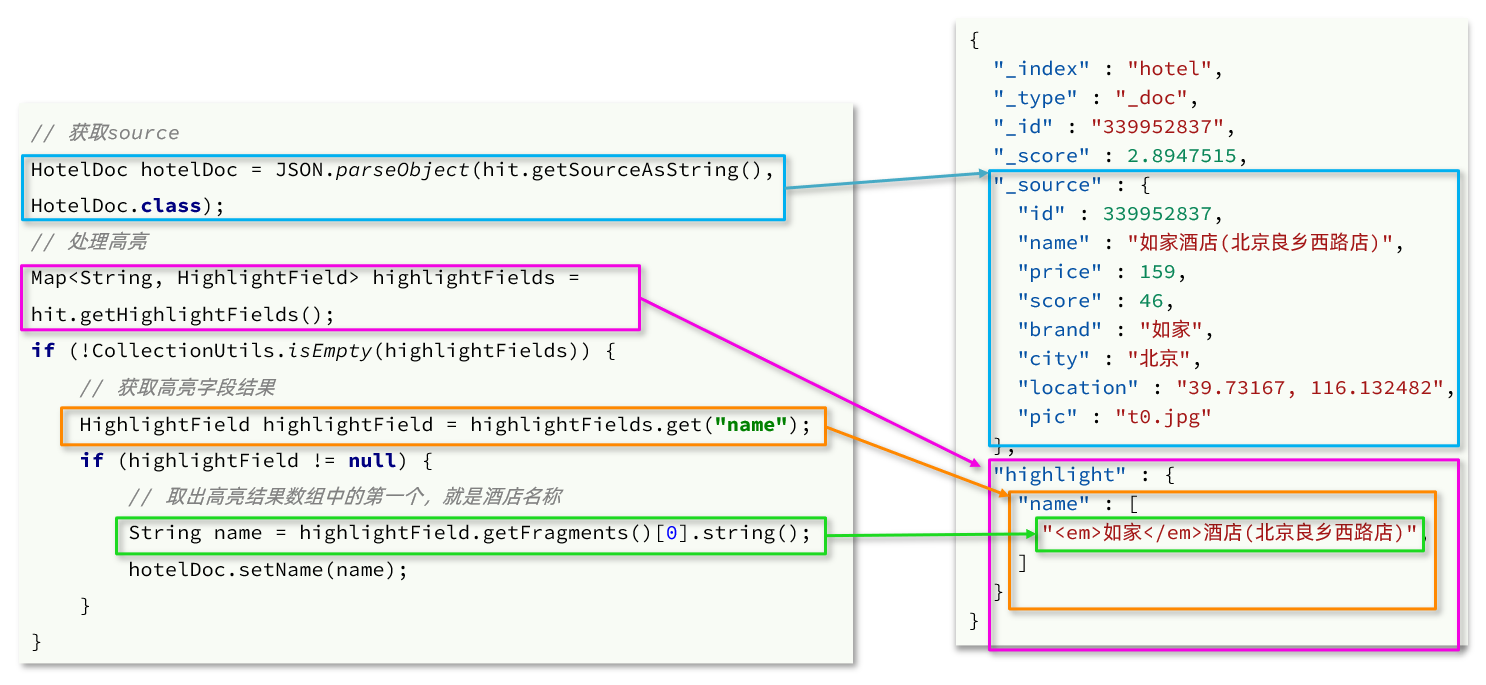
2)高亮结果解析
高亮的结果与查询的文档结果默认是分离的,并不在一起。
因此解析高亮的代码需要额外处理:
![image]()
代码解读:
- 第一步:从结果中获取source。hit.getSourceAsString(),这部分是非高亮结果,json字符串。还需要反序列为HotelDoc对象
- 第二步:获取高亮结果。hit.getHighlightFields(),返回值是一个Map,key是高亮字段名称,值是HighlightField对象,代表高亮值
- 第三步:从map中根据高亮字段名称,获取高亮字段值对象HighlightField
- 第四步:从HighlightField中获取Fragments,并且转为字符串。这部分就是真正的高亮字符串了
- 第五步:用高亮的结果替换HotelDoc中的非高亮结果
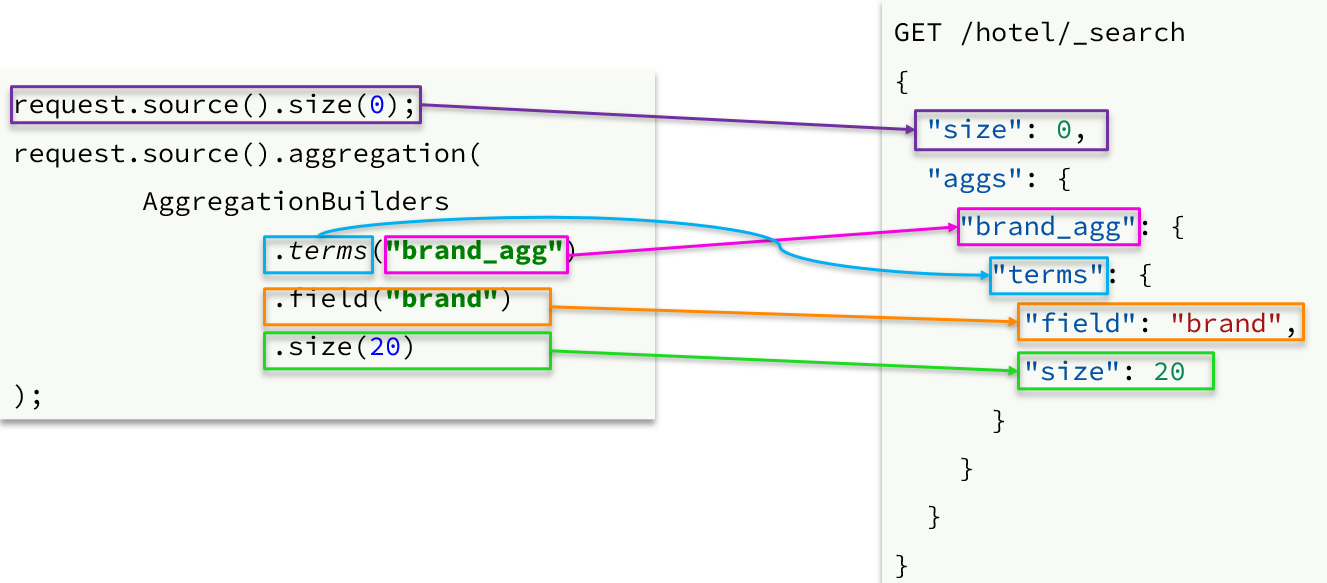
聚合
聚合条件与query条件同级别,因此需要使用request.source()来指定聚合条件。
聚合条件的语法:
![image]()
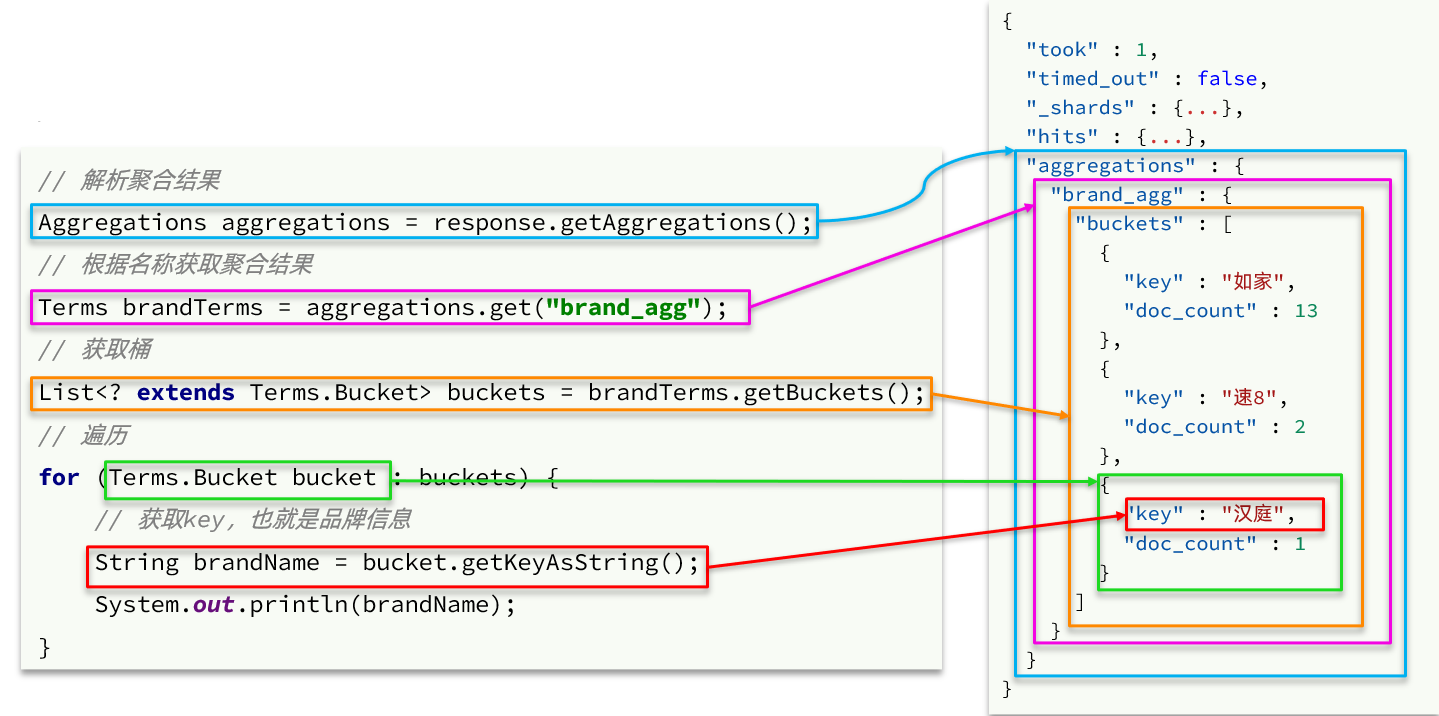
聚合的结果也与查询结果不同,API也比较特殊。不过同样是JSON逐层解析:
![image]()
示例代码,对按照机场id和航空公司进行聚合
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
|
@Test
public void testAggs() throws IOException {
SearchRequest request = new SearchRequest("kibana_sample_data_flights");
BoolQueryBuilder boolQuery = QueryBuilders.boolQuery();
boolQuery.must(QueryBuilders.termQuery("DestCountry", "CN"));
request.source().query(boolQuery);
request.source().size(0);
request.source().aggregation(AggregationBuilders.terms("airportIdAggs")
.size(10).field("DestAirportID").order(BucketOrder.count(false)));
request.source().aggregation(AggregationBuilders.terms("CarrierAggs")
.size(10).field("Carrier").order(BucketOrder.count(false)));
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
log.info("查询结果为 {}", response.toString());
Aggregations aggregations = response.getAggregations();
Terms airportIdTerms = aggregations.get("airportIdAggs");
List<? extends Terms.Bucket> airportIdBuckets = airportIdTerms.getBuckets();
for (Terms.Bucket idBucket : airportIdBuckets) {
log.info(" key {} 的数量为 {}", idBucket.getKeyAsString(), idBucket.getDocCount());
}
}
|
参考文章
- ElasticSearch (ES从入门到精通一篇就够了)