主要介绍自动补全功能,以及从mysql同步数据到elasticsearch。
自动补全
① 设置创建索引库(设置一个自动补全字段,类型为:completion)
② 重新插入数据
③ 查询(查询时要设置这个自动补全操作的名称,并且指定那个类型为completion的字段)
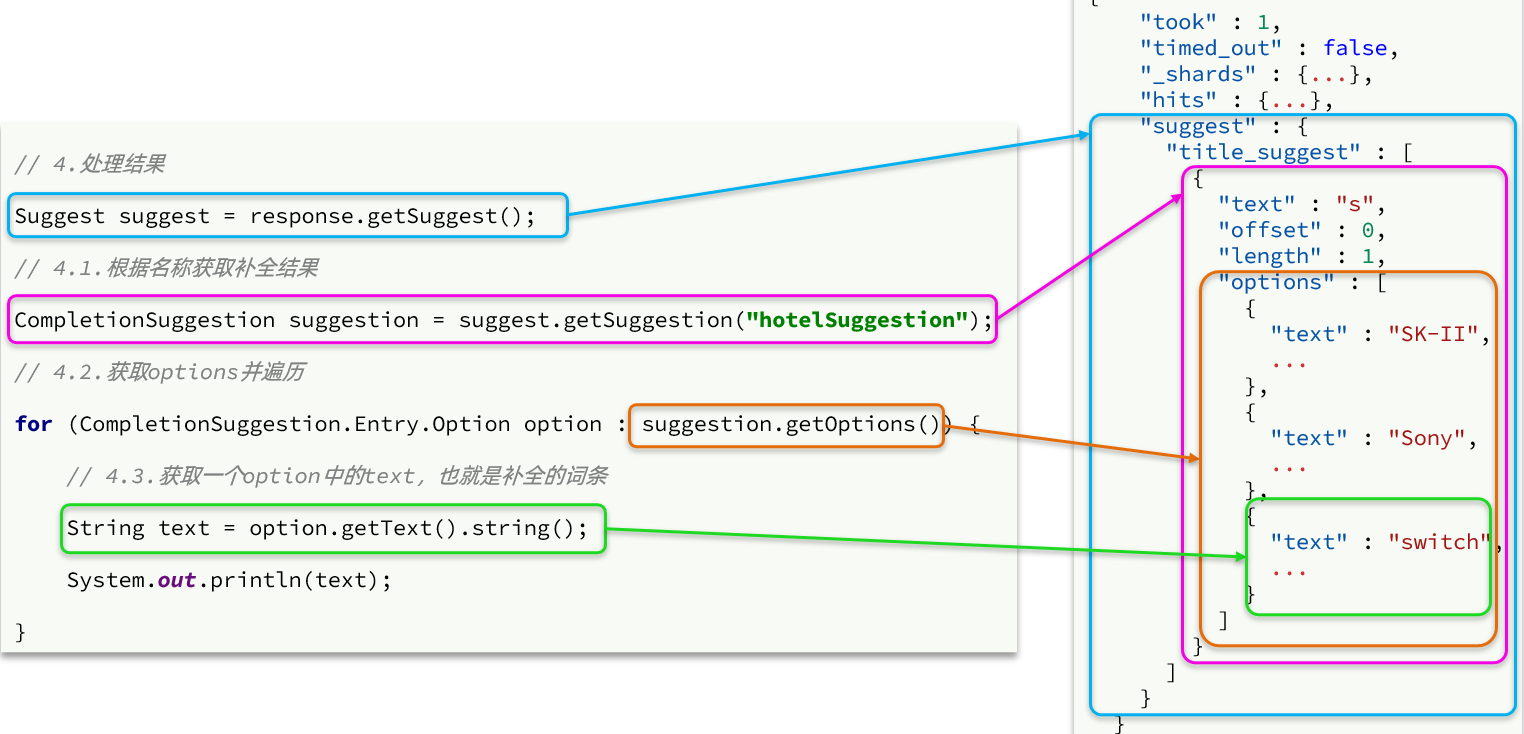
④ 分解结果(结果也需要根据之前设置这个自动查询操作的名称来取)
当用户在搜索框输入字符时,我们应该提示出与该字符有关的搜索项。
这种根据用户输入的字母,提示完整词条的功能,就是自动补全了。
拼音分词器
下载拼音分词器记得版本要和ES对应,不对应会报错
要实现根据字母做补全,就必须对文档按照拼音分词。在GitHub上恰好有elasticsearch的拼音分词插件。地址:https://github.com/infinilabs/analysis-pinyin
手动安装下载地址
在线安装
./elasticsearch-plugin install https://get.infini.cloud/elasticsearch/analysis-pinyin/7.12.1
自定义拼音分词器
如何使用拼音分词器?
如何自定义分词器?
拼音分词器注意事项?
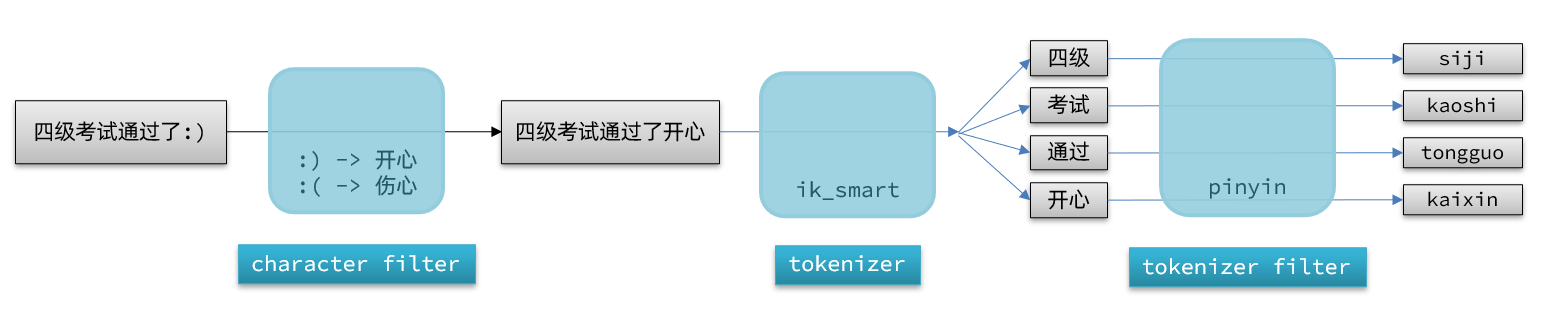
默认的拼音分词器会将每个汉字单独分为拼音,而我们希望的是每个词条形成一组拼音,需要对拼音分词器做个性化定制,形成自定义分词器。官网文档查询地址 。
elasticsearch中分词器(analyzer)的组成包含三部分:
- character filters:在tokenizer之前对文本进行处理。例如删除字符、替换字符
- tokenizer:将文本按照一定的规则切割成词条(term)。例如keyword,就是不分词;还有ik_smart
- tokenizer filter:将tokenizer输出的词条做进一步处理。例如大小写转换、同义词处理、拼音处理等
文档分词时会依次由这三部分来处理文档:
![image]()
声明自定义分词器的语法如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| PUT /pinyintest
{
"settings": {
"analysis": {
"analyzer": { // 自定义分词器
"my_analyzer": { // 分词器名称
"tokenizer": "ik_max_word",
"filter": "py"
}
},
"filter": { // 自定义tokenizer filter
"py": { // 过滤器名称
"type": "pinyin", // 过滤器类型,这里是pinyin
"keep_full_pinyin": false,
"keep_joined_full_pinyin": true,
"keep_original": true,
"limit_first_letter_length": 16,
"remove_duplicated_term": true,
"none_chinese_pinyin_tokenize": false
}
}
}
},
"mappings": {
"properties": {
"name": {
"type": "text",
"analyzer": "my_analyzer",
"search_analyzer": "ik_smart"
}
}
}
}
|
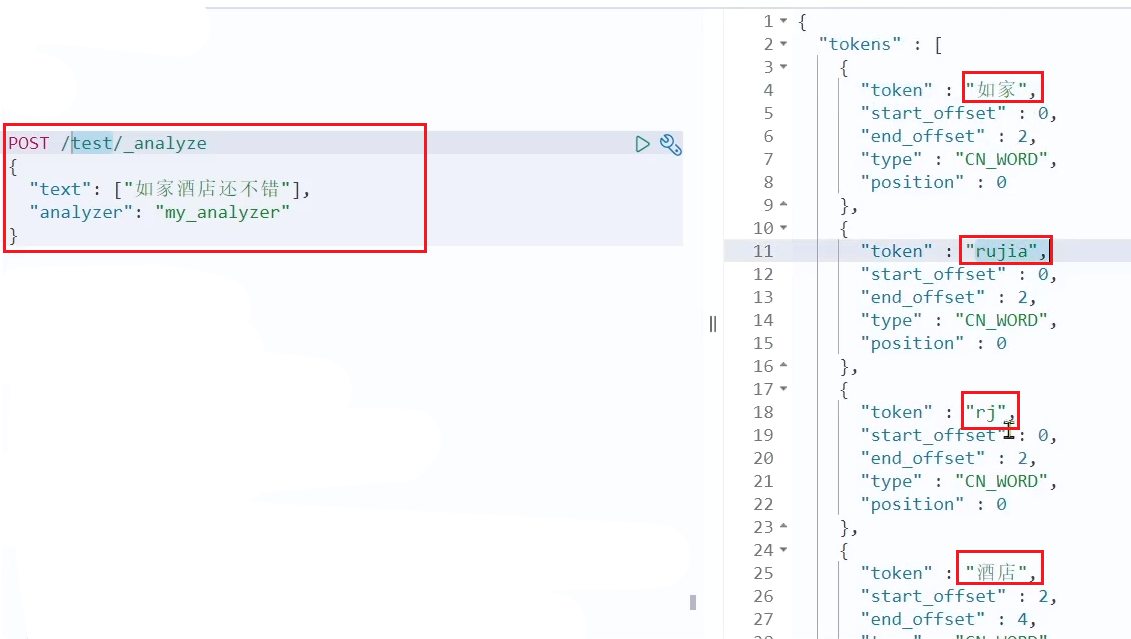
测试验证
![image]()
自动补全查询
三步骤:
① 创建索引库
② 插入数据
③ 查询的DSL语句
elasticsearch提供了Completion Suggester 查询来实现自动补全功能。这个查询会匹配以用户输入内容开头的词条并返回。为了提高补全查询的效率,对于文档中字段的类型有一些约束:
比如,索引库
1
2
3
4
5
6
7
8
9
| PUT /pinyintest/_mapping
{
"properties":{
"title" : {
"type": "keyword"
}
}
}
|
插入数据
1
2
3
4
5
6
7
8
9
| POST pinyintest/_doc
{
"title": ["honor", "vivo"]
}
POST pinyintest/_doc
{
"title": ["apple", "xiaomi"]
}
|
查询的DSL语句如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| // 自动补全查询
GET /test/_search
{
"suggest": {
"title_suggest": { //设置这个自动查询操作的名称
"text": "s", // 关键字
"completion": {
"field": "title", // 补全查询的字段名
"skip_duplicates": true, // 跳过重复的
"size": 10 // 获取前10条结果
}
}
}
}
|
自动补全嵌入项目
修改索引库映射结构
重点注意:
① all、name字段等要分词设置为自定义分词器(“analyzer”: “text_anlyzer”)(一般要分词,然后再对分词后的词语进行拼音处理),查询设置为最精简分词器(“search_analyzer”: “ik_smart”)
② 设置一个自动补全字段(如 suggestion) 类型必须为:completion,并且使用自定义分词器(一般不分词直接对整个词语进行拼音处理)
先删除之前的索引库,再设置如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
|
PUT /hotel
{
"settings": {
"analysis": {
"analyzer": {
"text_anlyzer": {
"tokenizer": "ik_max_word",
"filter": "py"
},
"completion_analyzer": {
"tokenizer": "keyword",
"filter": "py"
}
},
"filter": {
"py": {
"type": "pinyin",
"keep_full_pinyin": false,
"keep_joined_full_pinyin": true,
"keep_original": true,
"limit_first_letter_length": 16,
"remove_duplicated_term": true,
"none_chinese_pinyin_tokenize": false
}
}
}
},
"mappings": {
"properties": {
"id":{
"type": "keyword"
},
"name":{
"type": "text",
"analyzer": "text_anlyzer",
"search_analyzer": "ik_smart",
"copy_to": "all"
},
"address":{
"type": "keyword",
"index": false
},
"price":{
"type": "integer"
},
"score":{
"type": "integer"
},
"brand":{
"type": "keyword",
"copy_to": "all"
},
"city":{
"type": "keyword"
},
"starName":{
"type": "keyword"
},
"business":{
"type": "keyword",
"copy_to": "all"
},
"location":{
"type": "geo_point"
},
"pic":{
"type": "keyword",
"index": false
},
"all":{
"type": "text",
"analyzer": "text_anlyzer",
"search_analyzer": "ik_smart"
},
"suggestion":{
"type": "completion",
"analyzer": "completion_analyzer"
}
}
}
}
|
修改实体类
类型为completion的字段需要在构造方法里做组装
HotelDoc中要添加一个字段,用来做自动补全,内容可以是酒店品牌、城市、商圈等信息。按照自动补全字段的要求,最好是这些字段的数组。
因此我们在HotelDoc中添加一个suggestion字段,类型为List<String>,然后将brand、city、business等信息放到里面。
代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
| package cn.itcast.hotel.pojo;
import lombok.Data;
import lombok.NoArgsConstructor;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;
@Data
@NoArgsConstructor
public class HotelDoc {
private Long id;
private String name;
private String address;
private Integer price;
private Integer score;
private String brand;
private String city;
private String starName;
private String business;
private String location;
private String pic;
private Object distance;
private Boolean isAD;
private List<String> suggestion;
public HotelDoc(Hotel hotel) {
this.id = hotel.getId();
this.name = hotel.getName();
this.address = hotel.getAddress();
this.price = hotel.getPrice();
this.score = hotel.getScore();
this.brand = hotel.getBrand();
this.city = hotel.getCity();
this.starName = hotel.getStarName();
this.business = hotel.getBusiness();
this.location = hotel.getLatitude() + ", " + hotel.getLongitude();
this.pic = hotel.getPic();
if(this.business.contains("/")){
String[] arr = this.business.split("/");
this.suggestion = new ArrayList<>();
this.suggestion.add(this.brand);
Collections.addAll(this.suggestion, arr);
}else {
this.suggestion = Arrays.asList(this.brand, this.business);
}
}
}
|
重新导入数据
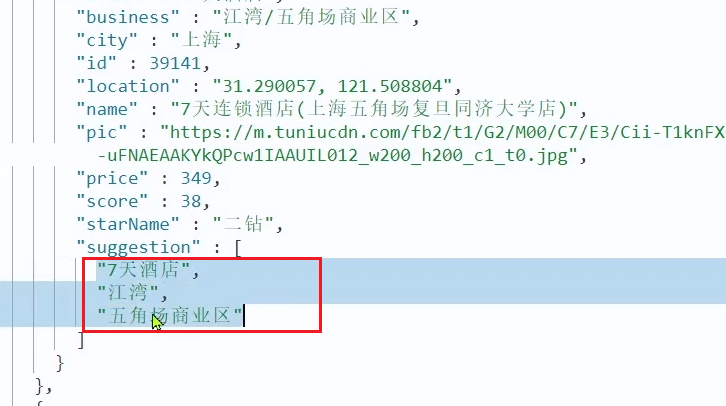
先删除数据,再重新执行之前编写的导入数据功能,可以看到新的酒店数据中包含了suggestion:
![image]()
自动补全的JavaAPI
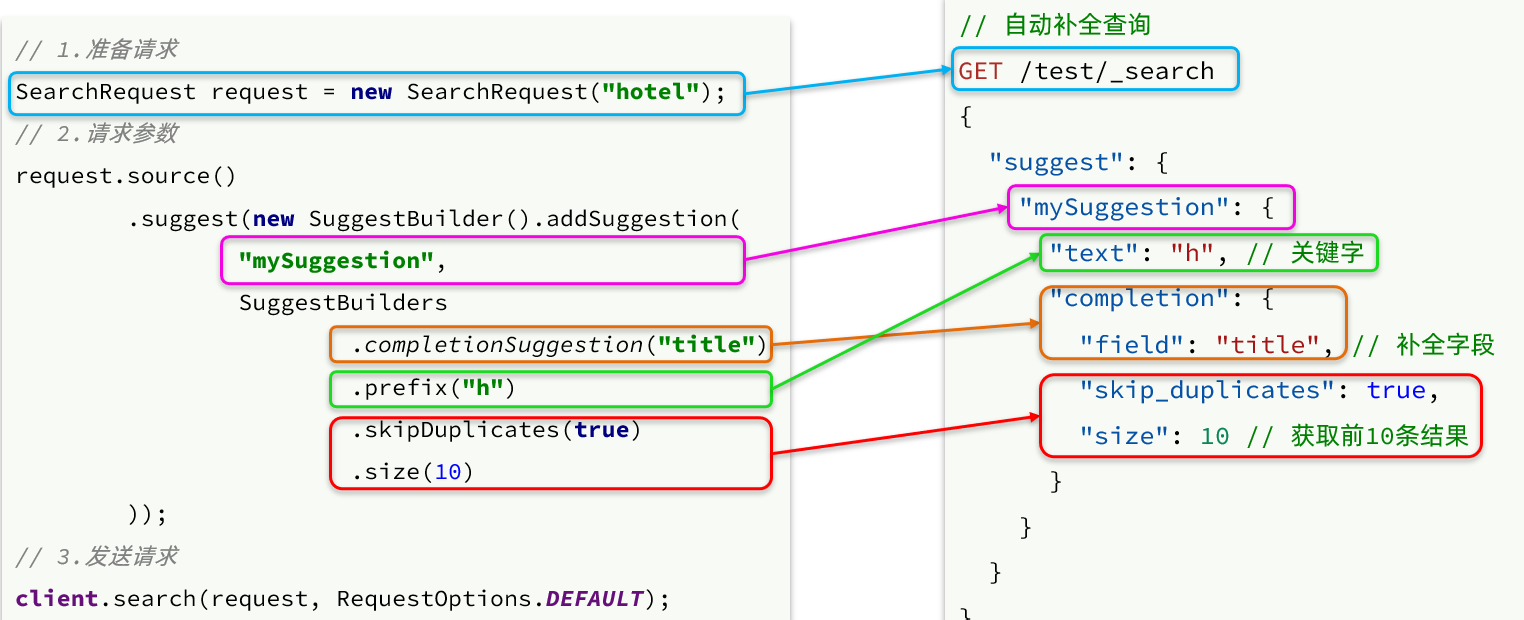
示例:
查询代码如下:
![image]()
解析结果代码如下:
![image]()
代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
|
@Test
public void testCompletion() throws IOException {
SearchRequest request = new SearchRequest("pinyintest");
request.source().suggest(new SuggestBuilder().addSuggestion(
"titleSuggestion",
SuggestBuilders.completionSuggestion("title")
.prefix("a")
.skipDuplicates(true)
.size(10)
));
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
log.info("查询结果为 {}", response.toString());
Suggest suggest = response.getSuggest();
CompletionSuggestion completionSuggestion = suggest.getSuggestion("titleSuggestion");
List<CompletionSuggestion.Entry.Option> list = completionSuggestion.getOptions();
for (CompletionSuggestion.Entry.Option option : list) {
log.info("自动补全的词为 {}", option.getText().toString());
}
}
|
ES与Mysql数据同步
elasticsearch中的数据来自于mysql数据库,因此mysql数据发生改变时,elasticsearch也必须跟着改变,这个就是elasticsearch与mysql之间的数据同步。
在微服务中, 负责数据增删改查的业务和负责搜索的业务可能在不同的微服务上面,数据同步该如何实现呢?
三种方法
常见的数据同步方案有三种:
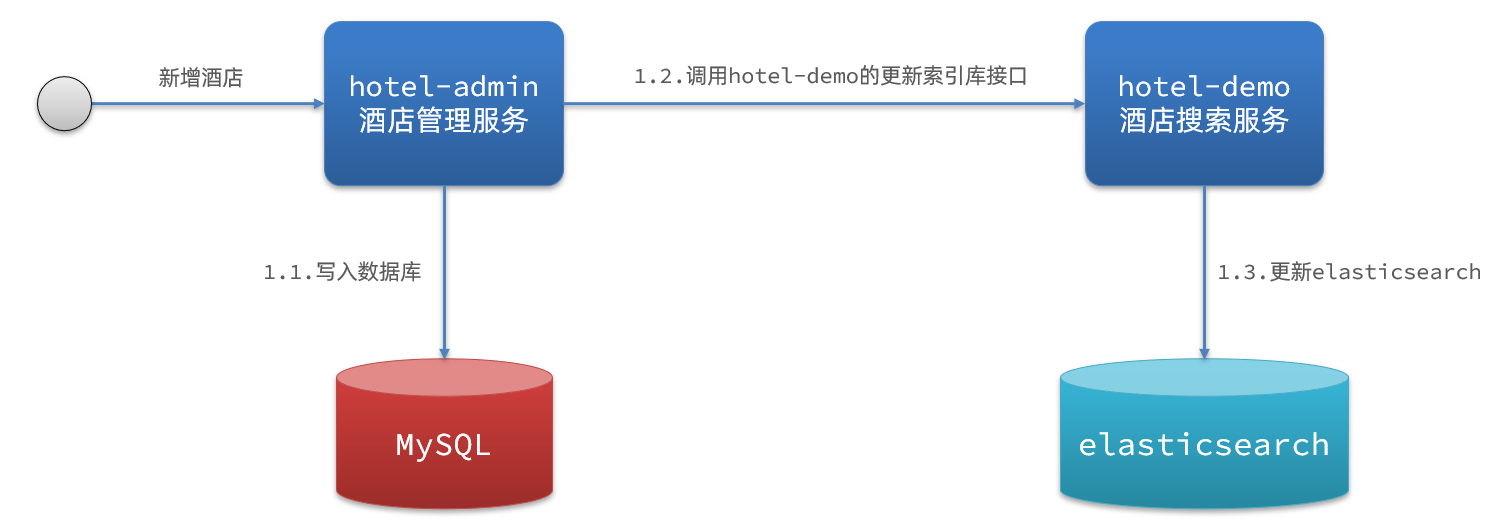
方式一:同步调用
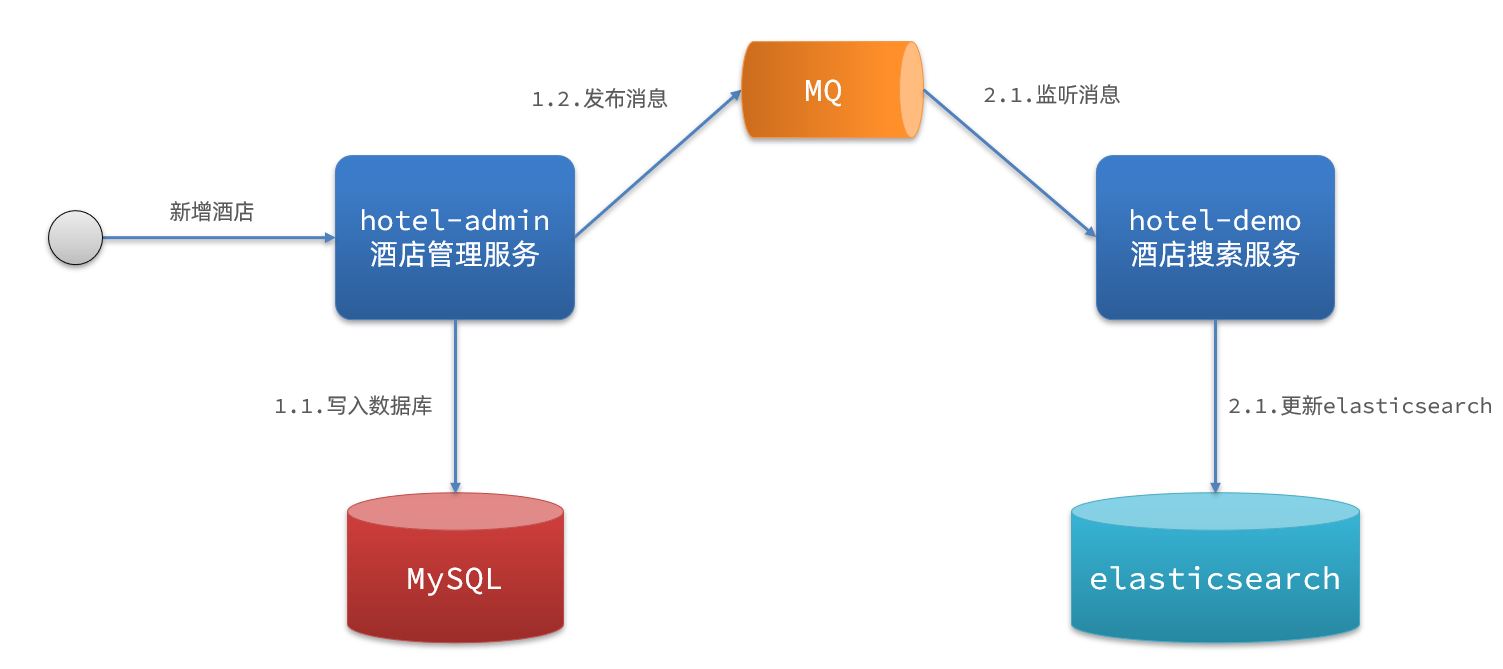
方式二:异步通知【常用】
- 优点:低耦合,实现难度一般
- 缺点:依赖mq的可靠性
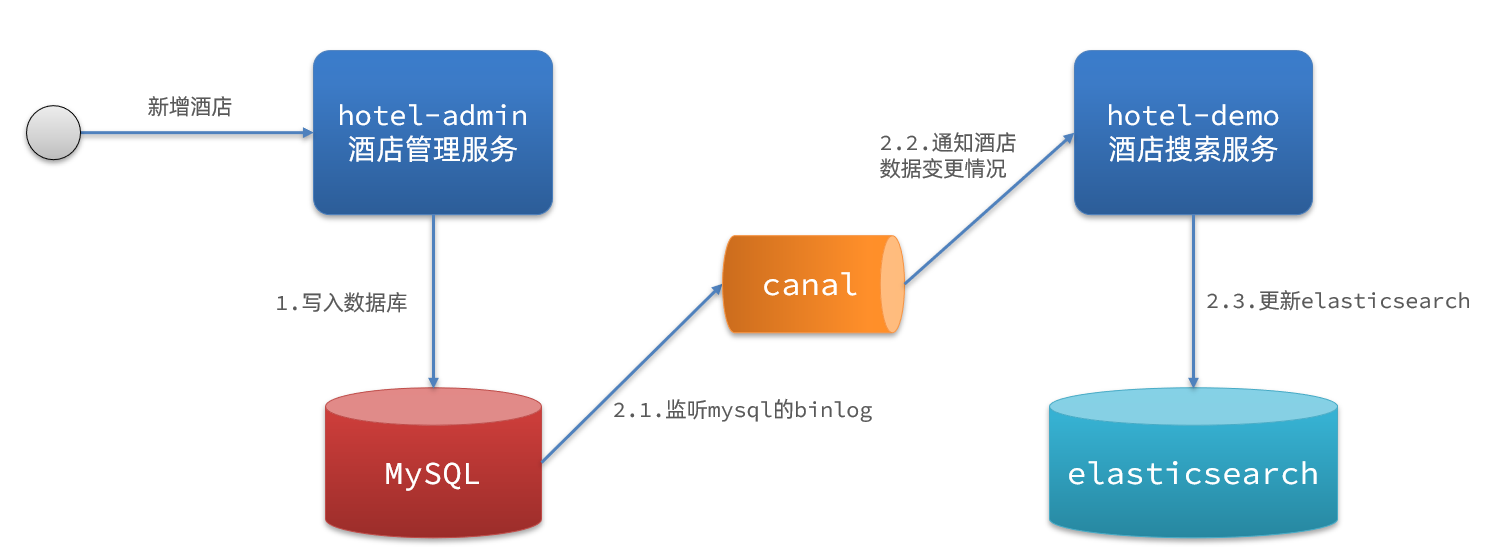
方式三:监听binlog
- 优点:完全解除服务间耦合
- 缺点:开启binlog增加数据库负担、实现复杂度高
同步调用
方案一:同步调用
![image]()
基本步骤如下:
- hotel-demo对外提供接口,用来修改elasticsearch中的数据
- 酒店管理服务在完成数据库操作后,直接调用hotel-demo提供的接口
异步通知
方案二:异步通知
![image]()
流程如下:
- hotel-admin对mysql数据库数据完成增、删、改后,发送MQ消息
- hotel-demo监听MQ,接收到消息后完成elasticsearch数据修改
监听binlog
方案三:监听binlog
![image]()
流程如下:
- 给mysql开启binlog功能
- mysql完成增、删、改操作都会记录在binlog中
- hotel-demo基于canal监听binlog变化,实时更新elasticsearch中的内容